
Tutorial
GPT-6.1 Terra API-Anbindung: curl, Python und OpenAI SDK
Zwei Anbindungswege über Responses und Chat Completions, Request-Schreibweise für Reasoning-Stufen, Bilderkennung, striktes JSON, Tool-Aufrufe und Caching sowie häufige Fehler.

TL;DR
- GPT-6.1 Terra (
gpt-6.1-terra) ist das Mittelklasse-Modell, das OpenAI am 26. Oktober 2026 veröffentlicht hat. Es kann Bilder lesen, Tools aufrufen und streng nach JSON-Schema ausgeben. Es ist bereits auf HiAPI verfügbar: Modellseite öffnen und online testen; bei der Registrierung erhältst du bis zu 2.000 Credits ($1). - Preis: pro Million Token $0,25 für Eingabe und $1,25 für Ausgabe. Eine kurze Antwort (etwa 90 Eingabe- und 80 Ausgabe-Token) kostet etwa $0,0001.
- Der schnellste Aufruf:
POST https://api.hiapi.ai/v1/responses,inputals Array übergeben,stream: true,store: false.
Was GPT-6.1 Terra kann
- 6 Reasoning-Stufen: none, low, medium (Standard), high, xhigh, max. Bei Batch-Aufgaben kann das Reasoning direkt deaktiviert werden (none).
- Bilder lesen: Text und Bilder in dieselbe Nachricht legen, Text ausgeben.
- Striktes JSON: Ein JSON-Schema vorgeben; die zurückgegebenen Felder und Typen entsprechen exakt dem Schema.
- Tool-Aufrufe: Das Modell entscheidet, welche Funktion aufgerufen und welche Parameter übergeben werden; nachdem du ausgeführt hast, gibst du das Ergebnis zurück, und es schreibt die endgültige Antwort.
Kontext 1,05 Mio. Token (maximal 922K pro Eingabe), maximale Ausgabe 128K, Wissensstand Juni 2026.
Beim folgenden Produktbild mit einem Schema für Produkteintrags-Informationen hat Terra in 10 Sekunden dieses JSON zurückgegeben:
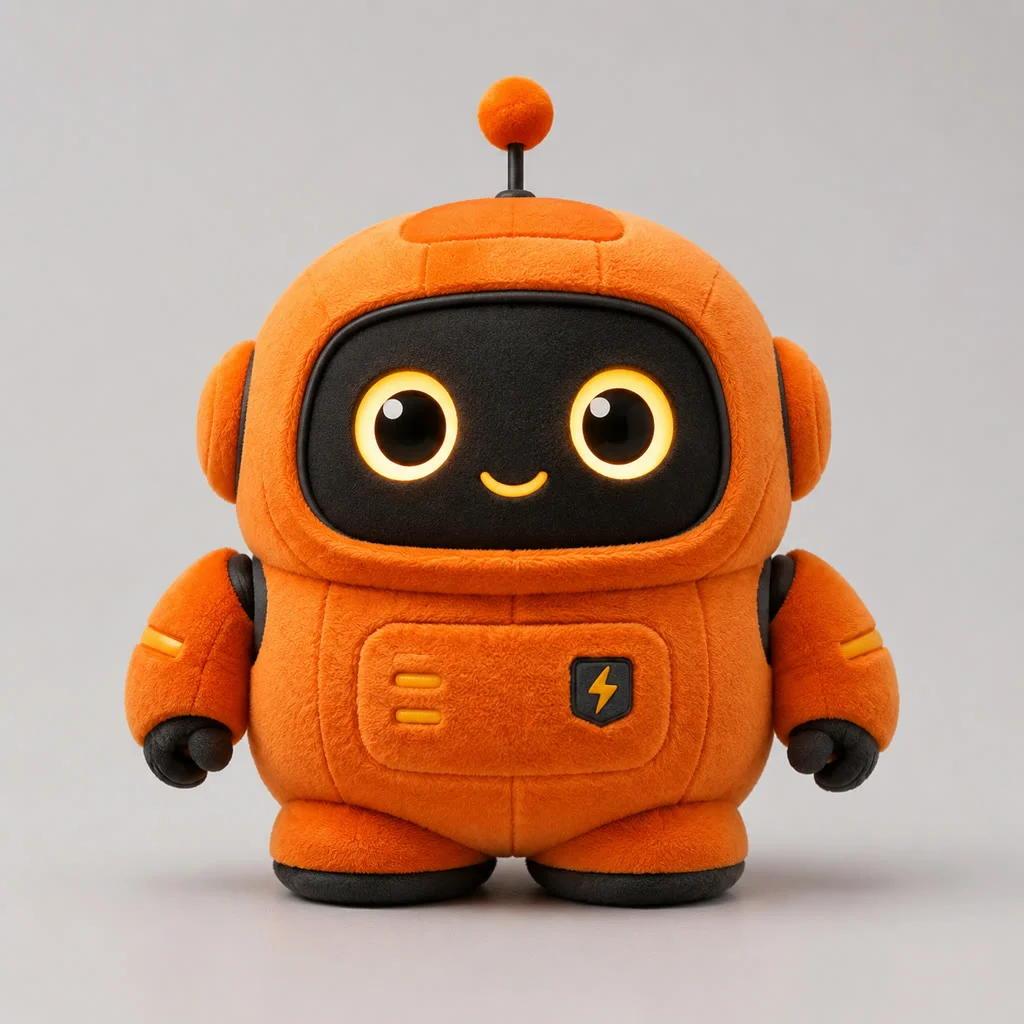
{"product_name":"Orangefarbene Roboter-Plüschpuppe","category":"Plüschtier","material":null,"main_color":"Orange","selling_points":["Roboter-Design mit niedlichem Aussehen","Orangefarbener Hauptkörper mit schwarzen Details, auffällige Farbkombination","Runde, dreidimensionale Form, geeignet als Dekoration oder Kuscheltier"],"target_buyer":null}
gpt-6.1-terra, medium, 438 Eingabe- / 163 Ausgabe-Token, $0,0003. Der Prompt verlangte „Felder, die nicht erkennbar sind, mit null füllen“, daher wurden Material und Zielgruppe beide als null zurückgegeben.
Welche der beiden Schnittstellen wählen
| Responses (Standard) | Chat Completions | |
|---|---|---|
| Adresse | POST /v1/responses |
POST /v1/chat/completions |
| Streaming | erfordert stream: true |
Streaming und Nicht-Streaming möglich |
| Feld für Reasoning-Stufe | reasoning.effort |
reasoning_effort |
| Feld für striktes JSON | text.format |
response_format |
| Geeignet für | neue Projekte, Bilderkennung und Tool-Aufrufe | bestehender OpenAI-Chat-Code, nur base URL austauschen |
Beide Schnittstellen verwenden https://api.hiapi.ai und denselben HiAPI-Key.
Zwei Einstiegswege
Browser (ohne Programmieren)
- GPT-6.1 Terra Modellseite öffnen und anmelden.
- Im Playground die Reasoning-Stufe wählen und eine Frage eingeben oder ein Bild einfügen.
- Die Antwort wird gestreamt angezeigt; nach Abschluss werden Token-Verbrauch, Dauer und geschätzte Kosten angezeigt.
API
- Auf der API-Keys-Seite in der Konsole einen Key erstellen und in der Umgebungsvariable
HIAPI_API_KEYspeichern. - Den curl unten kopieren, um den ersten Aufruf erfolgreich auszuführen.
- Auf Python umstellen und die Streaming-Ergebnisse nach Ereignistyp auslesen.
curl: der erste Aufruf
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Erkläre in drei Sätzen, was Idempotenz ist."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
Zurückgegeben wird ein SSE-Stream mit folgenden Ereignissen in dieser Reihenfolge:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (viele Male)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
Der Text steht im delta von response.output_text.delta, der Token-Verbrauch im response.usage des abschließenden response.completed. Im Stream können weitere Ereignistypen auftauchen; nach type verteilen und unbekannte einfach überspringen.
Python: Streaming lesen
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Erkläre in drei Sätzen, was Idempotenz ist."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # nach Bytes lesen, selbst mit UTF-8 dekodieren
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Zwei häufige Fallstricke:
- Verwende nicht
iter_lines(decode_unicode=True). Die Zeile vonresponse.completedüberschreitet oft 8 KB; requests dekodiert ohne bekannte Kodierung als latin-1, wodurch chinesische Zeichen zu Kauderwelsch werden. Nach Bytes lesen und dann mit UTF-8 dekodieren. - Auch Fehler liefern HTTP 200. Bei fehlgeschlagener Generierung kommt im Stream
response.failed, usage ist leer und es wird nichts berechnet. Separat prüfen und dann erneut versuchen.
Chat Completions: bestehenden Code direkt übernehmen
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Erkläre in drei Sätzen, was Idempotenz ist."}],
    "reasoning_effort": "low"
  }'
Mit dem offiziellen OpenAI-Python-SDK nur base_url und Key ändern:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Erkläre in drei Sätzen, was Idempotenz ist."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
Nicht-Streaming liefert direkt den vollständigen choices[0].message.content. Mit "stream": true erhältst du einen standardmäßigen Chunk-Stream, der mit data: [DONE] endet. Beim selben Kundenservice-Antwort-Prompt war die vollständige Antwort ohne Streaming nach 33 Sekunden da; mit Streaming erschien das erste Zeichen nach 2,5 Sekunden, und nach 4,5 Sekunden war es fertig. Für benutzergerichtete Szenarien Streaming verwenden.
Reasoning-Stufen
Bei Responses "reasoning": {"effort": "none"} schreiben, bei Chat "reasoning_effort": "none". Standard ist medium. Beim selben Anforderungszerlegungs-Prompt kostet medium einmal $0,002–0,004, max einmal $0,012–0,014. Token und Dauer der einzelnen Stufen siehe GPT-6.1 Terra API-Preise.
Bilder lesen
Im content derselben Nachricht ein Element input_image hinzufügen; das Bild verwendet eine öffentliche HTTPS-Adresse:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Beschreibe das Hauptmotiv des Bildes und zwei sichtbare Details."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
Striktes JSON
Im Request-Body text.format hinzufügen (bei Chat response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
Im strict-Modus muss jede Eigenschaft in required eingetragen werden; Felder, die leer sein dürfen, verwenden ["string", "null"]. Der zurückgegebene Text ist ein JSON, das direkt mit json.loads verarbeitet werden kann.
Tool-Aufrufe: zwei Runden
In der ersten Runde tools im Request mitgeben:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
Bei der Frage „Wo ist die Bestellung HX-20481?" schreibt das Modell keinen Text, sondern gibt nur einen function_call zurück: name ist get_order_status, arguments ist {"order_id":"HX-20481"}, dazu eine call_id.
In der zweiten Runde in input der Reihe nach ablegen: die ursprüngliche Benutzernachricht, den in der vorherigen Runde zurückgegebenen function_call und dann das Ergebnis deiner Funktionsausführung:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
Darauf antwortet das Modell: „Die Bestellung HX-20481 ist unterwegs, versendet von SF Express … voraussichtliche Zustellung: 30. Oktober 2026“. Beide Runden zusammen kosten etwa $0,00016. Bei der Rückgabe die call_id verwenden, nicht die mit fc_ beginnende id.
Cache-Treffer
Im Body prompt_cache_key übergeben, im Request-Header session_id mit demselben Wert übergeben, und der Anfang des Prompts bleibt wortwörtlich unverändert:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Wir haben ein Kundenservice-Handbuch mit etwa 3.290 Token als Anfang verwendet und nacheinander 4 Fragen gestellt; beim 4. Mal wurden 3.072 Cache-Token getroffen, und die Kosten sanken von etwa $0,001 auf $0,00013. Wie viele Treffer es gab, siehst du in input_tokens_details.cached_tokens in usage.
Parametertabelle (Responses)
| Feld | Erforderlich | Wert | Beschreibung |
|---|---|---|---|
model |
Ja | gpt-6.1-terra |
|
input |
Ja | Array | Nachrichten-Elemente; die Übergabe eines Strings gibt 400 zurück |
stream |
Ja | true |
false gibt 400 zurück |
store |
Nein | false |
Der Gesprächsverlauf wird vom Client gespeichert und jede Runde erneut gesendet |
reasoning.effort |
Nein | none / low / medium / high / xhigh / max | Standard ist medium |
text.format |
Nein | json_schema | Striktes JSON |
tools, tool_choice |
Nein | Funktionsdefinition | Tool-Aufrufe |
prompt_cache_key |
Nein | String | Zusammen mit dem Request-Header session_id für Cache-Treffer |
instructions |
Nein | String | Anforderungen an die Antwort |
temperature und top_p sind nicht einstellbar, und die maximale Antwortlänge kann ebenfalls nicht festgelegt werden; wenn du die Länge steuern musst, schreibe es in den Prompt.
Fehler, die dir begegnen werden
| Ursache | Statuscode | Rückgabe |
|---|---|---|
Stufe falsch geschrieben (z. B. "turbo") |
400 | reasoning.effort: is outside allowed values |
stream wurde auf false gesetzt |
400 | stream: must be true |
input nicht übergeben |
400 | input: is required |
| Zusätzliches unbekanntes Feld | 400 | request.zz: unregistered public parameter |
| Modellname falsch geschrieben | 400 | model_not_found, mit Request-ID |
| Generierung fehlgeschlagen | 200 | Im Stream kommt response.failed, error.code ist generation_service_unstable, keine Berechnung, einfach erneut versuchen |
Parameterfehler werden bereits beim Absenden mit 400 zurückgegeben; es wird nichts generiert und nichts berechnet.
Vor dem Go-live beachten
- Timeouts länger setzen: Bei Requests mit hoher Reasoning-Stufe und langen Antworten haben wir Fälle erlebt, die erst nach über 4 Minuten endeten. Client-Timeout mindestens auf 10 Minuten setzen.
- Bei Fehlern erneut versuchen:
response.failedund Netzwerkabbrüche beide als „einige Sekunden warten und erneut versuchen“ behandeln, höchstens 2–3 Wiederholungen. - Eingabe unter 272K halten: Bei Überschreitung wird der gesamte Request zum Langkontext-Preis abgerechnet, die Kosten sind fast doppelt so hoch.
- Lange Präfixe cachen: Bei festen Anfängen wie System-Prompt oder Wissensdatenbank
prompt_cache_keyundsession_idkonfigurieren.
Häufige Fragen
Kann man das offizielle OpenAI-SDK verwenden?
Ja. Request- und Antwortformat von Chat Completions entsprechen OpenAI; ändere die base URL auf https://api.hiapi.ai/v1 und tausche den Key gegen den HiAPI-Key aus.
Wie führt man mehrrundige Gespräche?
store muss false sein; der Server speichert keine Gespräche. In jeder Runde die benötigten historischen Nachrichten in input erneut mitsenden; der erneut gesendete Teil wird als Eingabe berechnet und kann mit Caching um den Großteil reduziert werden.
Welche Eingaben werden unterstützt?
Text und Bilder, Ausgabe ist Text. Im Playground der Modellseite können pro Anfrage maximal 4 Bilder übergeben werden, jedes höchstens 10 MB.
Wie wählt man zwischen GPT-6.1 Sol und Terra?
Terra kostet die Hälfte von Sol und hat zusätzlich die none-Stufe; in unseren Tests antwortete Sol schneller. Direkter Vergleich siehe GPT-6.1 Terra vs GPT-6.1 Sol.
Fertige Szenario-Prompts siehe GPT-6.1 Terra Prompt-Sammlung. Kopiere den curl oben, ersetze die Frage durch deine eigene und führe den ersten Aufruf erfolgreich aus; wenn du nicht programmieren möchtest, öffne die Modellseite und probiere es direkt aus.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
Recraft Creative Upscale Praxisbeispiele: Landschaften und Aquarell hochskalieren
Betrachten Sie die Texturveränderungen bei Holzhütte, See und Aquarellstadt, unterscheiden Sie vollständige Ergebnisse von Vorschauen und prüfen Sie neu gezeichnete Details.
-
Tutorial
Ungültiger OpenAI API key: Fehlerbehebung bei 401, Umgebungsvariablen und Projektkonfiguration
OpenAI 401, 403 und 429 unterscheiden, Umgebungsvariablen sowie Organisations- und Projekteinstellungen prüfen und Zugangsdaten mit einer schreibgeschützten Anfrage verifizieren.
-

Tutorial
Kling 4.0 Prompt-Sammlung: 6 Szenen zum direkten Kopieren für deine Videos
E-Commerce-Produkt, Food, Reise-Landschaft, Alltagsszene, leere Szene mit Ton und Bild-zu-Video – jede Szene mit echtem Ergebnisvideo, vollständigem Prompt und Ein-Klick-Vorausfüll-Link.