
Tutorial
Guía de integración a la API de GPT-6.1 Terra: curl, Python y OpenAI SDK
Dos formas de integración, Responses y Chat Completions: cómo escribir las solicitudes para niveles de razonamiento, lectura de imágenes, JSON estricto, llamadas a herramientas y caché, además de los errores más habituales.

TL;DR
- GPT-6.1 Terra (
gpt-6.1-terra) es el modelo de gama media que OpenAI lanzó el 26 de octubre de 2026: puede leer imágenes, invocar herramientas y generar salidas estrictamente según un JSON schema. Ya está disponible en HiAPI; abre la página del modelo para probarlo en línea; al registrarte recibes hasta 2.000 créditos ($1). - Precio: $0.25 por millón de tokens de entrada y $1.25 por millón de tokens de salida. Una respuesta breve (unos 90 tokens de entrada y 80 de salida) cuesta aproximadamente $0.0001.
- La forma más rápida de llamarlo:
POST https://api.hiapi.ai/v1/responses, pasarinputcomo array,stream: trueystore: false.
Qué puede hacer GPT-6.1 Terra
- 6 niveles de razonamiento: none, low, medium (predeterminado), high, xhigh y max. En tareas por lotes puedes desactivar el razonamiento (none).
- Lectura de imágenes: texto e imágenes en el mismo mensaje, y la salida es texto.
- JSON estricto: proporcionas un JSON schema y los campos y tipos devueltos siguen exactamente el schema.
- Llamada a herramientas: el modelo decide qué función invocar y con qué parámetros; tú ejecutas y devuelves el resultado, y él redacta la respuesta final.
Contexto de 1,05 M de tokens (máximo 922K por entrada), salida máxima de 128K y conocimiento hasta junio de 2026.
Con la siguiente imagen de producto y un schema para información de publicación, Terra devolvió este JSON en 10 segundos:
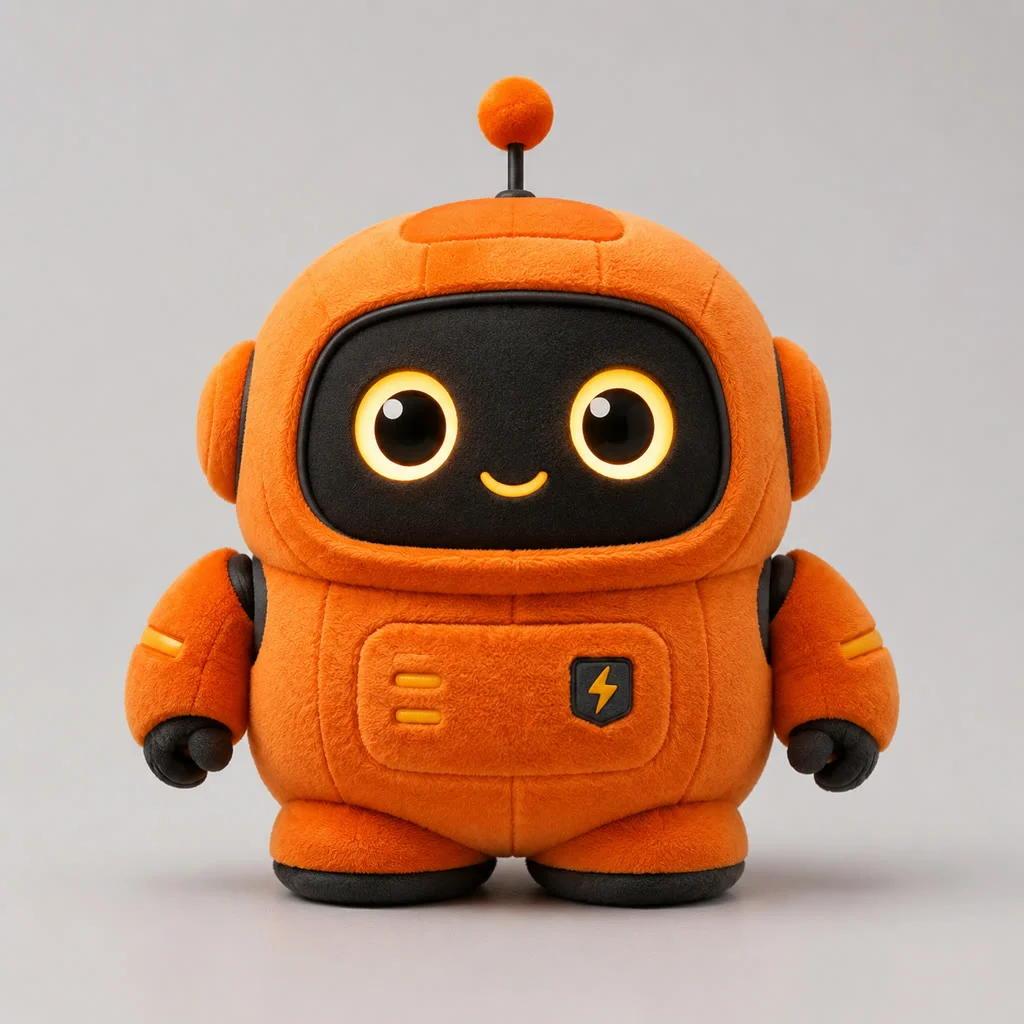
{"product_name":"Muñeco de peluche robot naranja","category":"Peluche","material":null,"main_color":"Naranja","selling_points":["Diseño con forma de robot y aspecto adorable","Cuerpo naranja con detalles negros y una combinación de colores llamativa","Forma redondeada y tridimensional, ideal como figura decorativa o peluche de compañía"],"target_buyer":null}
gpt-6.1-terra, medium, 438 tokens de entrada / 163 de salida, $0.0003. El prompt pedía «rellena con null los campos que no se puedan determinar», por eso material y público objetivo devolvieron null.
Cómo elegir entre las dos interfaces
| Responses (predeterminada) | Chat Completions | |
|---|---|---|
| Dirección | POST /v1/responses |
POST /v1/chat/completions |
| Streaming | Obligatorio stream: true |
Se admite con y sin streaming |
| Campo de nivel de razonamiento | reasoning.effort |
reasoning_effort |
| Campo de JSON estricto | text.format |
response_format |
| Recomendada para | Proyectos nuevos, lectura de imágenes y llamadas a herramientas | Código existente de OpenAI Chat cambiando solo la base URL |
Ambas interfaces usan https://api.hiapi.ai y la misma clave de HiAPI.
Dos rutas para empezar
Navegador (sin escribir código)
- Abre la página del modelo GPT-6.1 Terra e inicia sesión.
- En el Playground, elige el nivel de razonamiento e introduce una pregunta o pega una imagen.
- La respuesta se muestra en streaming; al terminar verás el uso de tokens, el tiempo y el coste estimado.
API
- Crea una clave en la página API Keys de la consola y guárdala en la variable de entorno
HIAPI_API_KEY. - Copia el siguiente curl y ejecuta tu primera llamada.
- Pasa a Python y lee los resultados en streaming según el tipo de evento.
curl: primera llamada
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Explica en tres frases qué es la idempotencia."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
Devuelve un flujo SSE con los eventos en este orden:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (muchas veces)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
El texto está en delta de response.output_text.delta, y el uso de tokens en response.usage del último response.completed. En el flujo pueden aparecer otros tipos de eventos; distribúyelos según type y omite los que no reconozcas.
Python: lectura en streaming
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Explica en tres frases qué es la idempotencia."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # Lee por bytes y decodifica tú mismo en UTF-8
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Dos errores fáciles de cometer:
- No uses
iter_lines(decode_unicode=True). La línea deresponse.completedsuele superar los 8KB y, cuando requests no conoce la codificación, decodifica en latin-1 y el chino se corrompe. Lee por bytes y decodifica en UTF-8. - Los fallos también devuelven HTTP 200. Cuando falla la generación, en el flujo llega
response.failed, con usage vacío y sin cargo. Debes detectarlo aparte y reintentar.
Chat Completions: reutiliza tu código existente
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Explica en tres frases qué es la idempotencia."}],
    "reasoning_effort": "low"
  }'
Con el SDK oficial de OpenAI para Python, solo cambia base_url y la clave:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Explica en tres frases qué es la idempotencia."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
Sin streaming devuelve directamente el choices[0].message.content completo. Con "stream": true es un flujo de chunks estándar que termina con data: [DONE]. Con el mismo prompt de respuesta de atención al cliente, sin streaming tardamos 33 segundos en obtener la respuesta completa; con streaming, el primer carácter apareció en 2,5 segundos y terminó en 4,5 segundos. Usa streaming en escenarios orientados al usuario.
Niveles de razonamiento
En Responses se escribe "reasoning": {"effort": "none"}; en Chat, "reasoning_effort": "none". El valor predeterminado es medium. Con el mismo prompt de desglose de requisitos, medium cuesta $0.002–0.004 por llamada y max, $0.012–0.014. Consulta los tokens y tiempos de cada nivel en Precios de la API de GPT-6.1 Terra.
Lectura de imágenes
Añade un elemento input_image en el content del mismo mensaje; la imagen debe estar en una URL HTTPS pública:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Describe el sujeto de la imagen y dos detalles visibles."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
JSON estricto
Añade text.format al cuerpo de la solicitud (en Chat se usa response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
En modo strict, todas las propiedades deben incluirse en required; los campos que pueden ser nulos usan ["string", "null"]. El cuerpo devuelto es un JSON que puedes pasar directamente a json.loads.
Llamada a herramientas: dos rondas
En la primera ronda incluye tools en la solicitud:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
Si preguntas «¿Dónde está el pedido HX-20481?», el modelo no redacta texto: devuelve solo un function_call cuyo name es get_order_status y cuyos arguments son {"order_id":"HX-20481"}, junto con un call_id.
En la segunda ronda, coloca en input en este orden: el mensaje original del usuario, el function_call devuelto en la ronda anterior y el resultado de ejecutar tu función:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
Con eso el modelo responde: «El pedido HX-20481 está en tránsito, transportado por SF Express… Entrega estimada: 30 de octubre de 2026». Las dos rondas cuestan unos $0.00016 en total. Al devolver el resultado usa call_id, no el id que empieza por fc_.
Acierto de caché
Pasa prompt_cache_key en el cuerpo y un session_id con el mismo valor en las cabeceras, manteniendo intacto carácter por carácter el inicio del prompt:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Usamos como inicio un manual de atención al cliente de unos 3.290 tokens e hicimos 4 preguntas seguidas; la cuarta acertó 3.072 tokens en caché y el coste de esa llamada bajó de unos $0.001 a $0.00013. Para ver cuántos acertaste, consulta input_tokens_details.cached_tokens en usage.
Tabla de parámetros (Responses)
| Campo | Obligatorio | Valores | Descripción |
|---|---|---|---|
model |
Sí | gpt-6.1-terra |
|
input |
Sí | Array | Elementos de mensaje; si pasas una cadena devuelve 400 |
stream |
Sí | true |
Si pasas false devuelve 400 |
store |
No | false |
El historial de conversación lo guarda el cliente y se reenvía en cada ronda |
reasoning.effort |
No | none / low / medium / high / xhigh / max | Predeterminado: medium |
text.format |
No | json_schema | JSON estricto |
tools, tool_choice |
No | Definición de función | Llamada a herramientas |
prompt_cache_key |
No | Cadena | Junto con la cabecera session_id para acertar en caché |
instructions |
No | Cadena | Requisitos de la respuesta |
temperature y top_p no son ajustables, y tampoco se puede fijar un límite de longitud de la respuesta; si necesitas controlar la longitud, indícalo en el prompt.
Errores que encontrarás
| Causa | Código de estado | Respuesta |
|---|---|---|
Nivel mal escrito (p. ej. "turbo") |
400 | reasoning.effort: is outside allowed values |
stream con false |
400 | stream: must be true |
Falta input |
400 | input: is required |
| Campo desconocido de más | 400 | request.zz: unregistered public parameter |
| Nombre de modelo incorrecto | 400 | model_not_found, con request ID |
| Fallo de generación | 200 | En el flujo llega response.failed, error.code es generation_service_unstable, no se cobra y basta con reintentar |
Los errores de parámetros se devuelven como 400 al enviar la solicitud; no se genera nada ni se cobra.
Antes de pasar a producción
- Configura un timeout más largo: con niveles de razonamiento altos y respuestas largas, hemos visto solicitudes que tardan más de 4 minutos en terminar. Configura el timeout del cliente en al menos 10 minutos.
- Reintenta los fallos: tanto
response.failedcomo las interrupciones de red se tratan como «espera unos segundos y reintenta», con un máximo de 2–3 reintentos. - Mantén la entrada por debajo de 272K: si la superas, toda la solicitud se factura a precio de contexto largo y el coste casi se duplica.
- Usa caché para prefijos largos: para inicios fijos como prompts de sistema o bases de conocimiento, configura
prompt_cache_keyysession_id.
Preguntas frecuentes
¿Se puede usar el SDK oficial de OpenAI?
Sí. El formato de solicitud y respuesta de Chat Completions es compatible con OpenAI; cambia la base URL a https://api.hiapi.ai/v1 y la clave por tu clave de HiAPI.
¿Cómo se hace una conversación multiturno?
store debe ser false; el servidor no guarda la conversación. En cada ronda, incluye los mensajes históricos necesarios en input y reenvíalos; la parte reenviada se factura como entrada y, con caché, puedes ahorrar buena parte del coste.
¿Qué entradas admite?
Texto e imágenes; la salida es texto. En el Playground de la página del modelo puedes subir hasta 4 imágenes a la vez, de 10 MB como máximo cada una.
¿Cómo elegir entre GPT-6.1 Sol y este modelo?
Terra cuesta la mitad que Sol y añade el nivel none; en nuestras pruebas, Sol respondía más rápido. Consulta la comparación con las mismas preguntas en GPT-6.1 Terra vs GPT-6.1 Sol.
Para prompts de casos de uso ya listos, consulta Recopilatorio de prompts de GPT-6.1 Terra. Copia el curl anterior, cambia la pregunta por la tuya y completa tu primera llamada; si no quieres escribir código, abre la página del modelo y pruébalo directamente.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Casos de Recraft Creative Upscale: escalado de paisajes y acuarela
Observa los cambios de textura en la cabaña, el lago y el pueblo en acuarela, distingue entre resultado completo y vista previa, y revisa los detalles redibujados.
-
Tutorial
Clave de API de OpenAI no válida: 401, variables de entorno y solución de problemas de configuración del proyecto
Distingue entre los errores 401, 403 y 429 de OpenAI, revisa las variables de entorno y la configuración de la organización y del proyecto, y valida las credenciales con una solicitud de solo lectura.
-

Tutorial
Guía completa de prompts de Kling 4.0: 6 escenas para copiar y generar vídeos directamente
Producto de e-commerce, comida, paisajes de viaje, escenas cotidianas, planos vacíos con sonido y vídeo a partir de imagen: cada escena incluye un vídeo real, el prompt completo y un enlace con autorrelleno en un clic.