
チュートリアル
GPT-6.1 Terra API 接続ガイド:curl、Python、OpenAI SDK
Responses と Chat Completions の 2 通りの接続方法、推論レベル、画像読み取り、厳格な JSON、ツール呼び出し、キャッシュのリクエストの書き方、およびよくあるエラー。

TL;DR
- GPT-6.1 Terra(
gpt-6.1-terra)は OpenAI が 2026 年 10 月 26 日にリリースしたミッドレンジモデルで、画像の読み取り、ツール呼び出し、JSON schema に厳密に従った出力が可能です。すでに HiAPI で公開されており、モデルページを開いてオンラインで試せます。登録すると最大 2,000 クレジット($1)が付与されます。 - 料金:100 万 token あたり入力 $0.25、出力 $1.25。短い返答 1 回(約 90 入力 / 80 出力 token)で約 $0.0001。
- 最も手早い呼び出し方:
POST https://api.hiapi.ai/v1/responsesで、inputに配列を渡し、stream: true、store: false。
GPT-6.1 Terra にできること
- 6 つの推論レベル:none、low、medium(デフォルト)、high、xhigh、max。バッチタスクでは推論を無効(none)にできます。
- 画像の読み取り:テキストと画像を同じメッセージに入れ、テキストを出力します。
- 厳格な JSON:JSON schema を渡すと、返されるフィールドと型が schema 通りになります。
- ツール呼び出し:モデルがどの関数をどの引数で呼ぶかを判断し、あなたが実行した結果を返すと、モデルが最終回答を書きます。
コンテキスト 1.05M token(1 回の入力は最大 922K)、最大出力 128K、知識カットオフは 2026 年 6 月です。
以下の商品画像に出品情報の schema を付けて Terra に渡すと、10 秒でこのような JSON を返しました:
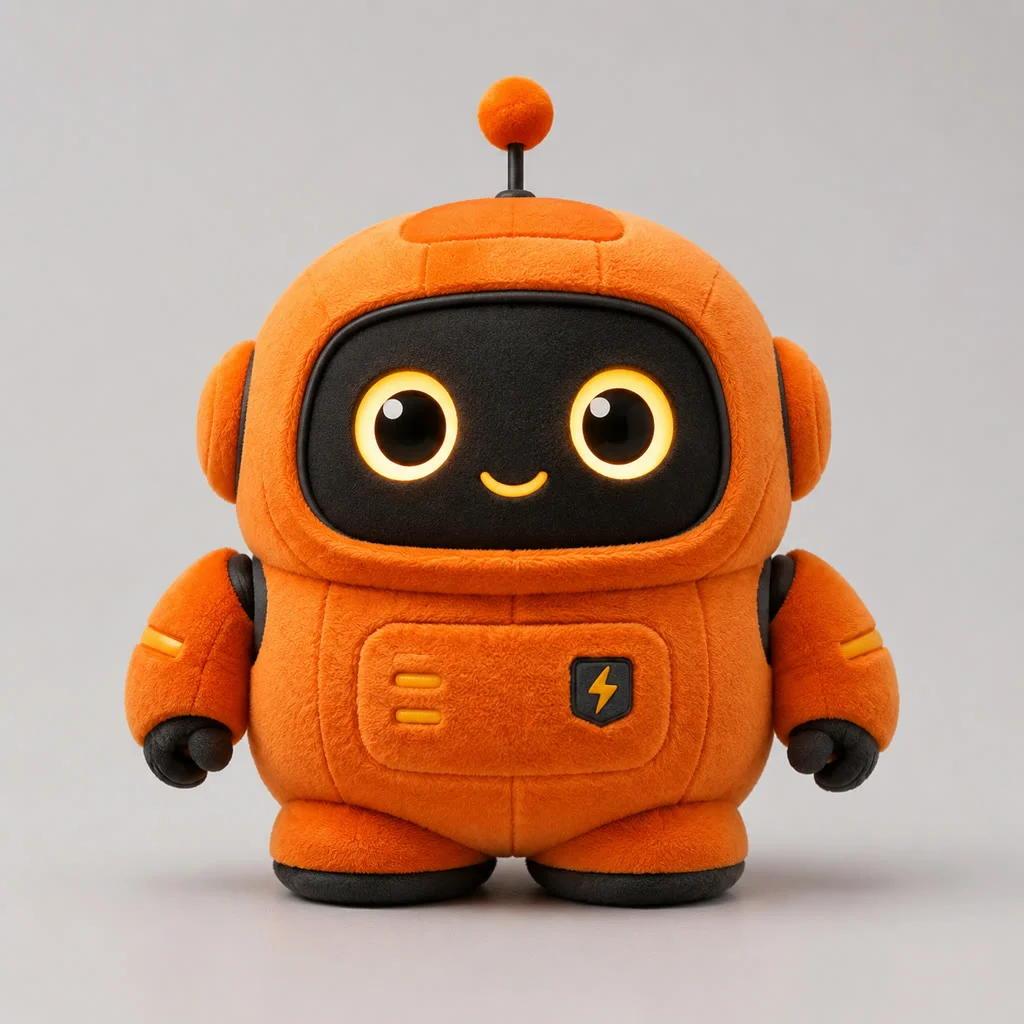
{"product_name":"オレンジ色のロボットぬいぐるみ","category":"ぬいぐるみ","material":null,"main_color":"オレンジ","selling_points":["ロボット型のデザインで見た目がかわいい","オレンジの本体に黒いディテールを組み合わせた印象的な配色","丸みのある立体的な造型で、置物や寄り添うぬいぐるみに最適"],"target_buyer":null}
gpt-6.1-terra、medium、438 入力 / 163 出力 token、$0.0003。プロンプトで「判別できないフィールドは null で埋める」と指定したため、材質と対象購入者はいずれも null が返りました。
2 つの API の選び方
| Responses(デフォルト) | Chat Completions | |
|---|---|---|
| エンドポイント | POST /v1/responses |
POST /v1/chat/completions |
| ストリーミング | stream: true 必須 |
ストリーミングも非ストリーミングも可 |
| 推論レベルフィールド | reasoning.effort |
reasoning_effort |
| 厳格 JSON フィールド | text.format |
response_format |
| 適する用途 | 新規プロジェクト、画像読み取りやツール呼び出しが必要な場合 | 既存の OpenAI Chat コードの base URL を変えるだけ |
どちらの API も https://api.hiapi.ai と同じ HiAPI key を使います。
2 つの導入ルート
ブラウザ(コード不要)
- GPT-6.1 Terra モデルページを開き、ログインします。
- Playground で推論レベルを選び、質問を入力するか画像を貼り付けます。
- 回答はストリーミング表示され、完了すると token 使用量、所要時間、概算費用が表示されます。
API
- コンソールの API Keys ページで key を作成し、環境変数
HIAPI_API_KEYに保存します。 - 以下の curl をコピーして最初の呼び出しを通します。
- Python に切り替え、イベントタイプに応じてストリーミング結果を読み取ります。
curl:最初の呼び出し
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "冪等性とは何かを三文で説明してください。"}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
返ってくるのは SSE ストリームで、イベントは次の順に並びます:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta(多数回)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
本文は response.output_text.delta の delta に、token 使用量は最後の response.completed の response.usage に入っています。ストリームには他のイベントタイプが現れることもあるので、type で振り分け、知らないものはスキップすれば問題ありません。
Python:ストリーミング読み取り
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "冪等性とは何かを三文で説明してください。"}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # バイト単位で読み、自分で UTF-8 デコードする
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
つまずきやすいポイントが 2 つあります:
iter_lines(decode_unicode=True)は使わないでください。response.completedの行はしばしば 8KB を超え、requests はエンコーディングが分からないと latin-1 でデコードするため、中国語が文字化けします。バイト単位で読み、UTF-8 でデコードしてください。- 失敗時も HTTP 200 が返ります。生成に失敗すると、ストリームには
response.failedが流れ、usage は空で課金されません。個別に判定してからリトライしてください。
Chat Completions:既存コードをそのまま流用
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "冪等性とは何かを三文で説明してください。"}],
    "reasoning_effort": "low"
  }'
OpenAI 公式の Python SDK を使う場合は、base_url と key だけを変更します:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "冪等性とは何かを三文で説明してください。"}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
非ストリーミングでは完全な choices[0].message.content が直接返ります。"stream": true を加えると標準的な chunk ストリームになり、data: [DONE] で終了します。同じカスタマーサポート返信のプロンプトで、非ストリーミングは 33 秒で完全な回答を得られ、ストリーミングは 2.5 秒で最初の文字が出て 4.5 秒で終了しました。ユーザー向けの場面ではストリーミングを使いましょう。
推論レベル
Responses では "reasoning": {"effort": "none"}、Chat では "reasoning_effort": "none" と書きます。デフォルトは medium。同じ要件分解のプロンプトで、medium は 1 回 $0.002〜0.004、max は 1 回 $0.012〜0.014。各レベルの token と所要時間は GPT-6.1 Terra API の料金を参照してください。
画像の読み取り
同じメッセージの content に input_image を 1 項目追加し、画像は公開 HTTPS アドレスを使います:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "画像の主体と、確認できる細部を 2 つ説明してください。"},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
厳格な JSON
リクエストボディに text.format を追加します(Chat では response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
strict モードでは、すべてのプロパティを required に書き、空を許すフィールドは ["string", "null"] にします。返される本文は、そのまま json.loads できる JSON です。
ツール呼び出し:2 ラウンド
1 ラウンド目はリクエストに tools を含めます:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
「注文 HX-20481 はどこですか?」と聞くと、モデルは本文を書かず、function_call を 1 つだけ返します。name は get_order_status、arguments は {"order_id":"HX-20481"} で、さらに call_id が付きます。
2 ラウンド目では、input に順に、元のユーザーメッセージ、前ラウンドで返された function_call、そして関数実行結果を入れます:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
モデルはこれに基づいて「注文 HX-20481 は輸送中で、SF Express が配送を担当しています……到着予定:2026 年 10 月 30 日」と答えます。2 ラウンド合計で約 $0.00016。返送時は fc_ で始まる id ではなく、call_id を使います。
キャッシュのヒット
body に prompt_cache_key を渡し、リクエストヘッダーに同じ値の session_id を渡し、プロンプト冒頭の部分は一字一句変えずに保ちます:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
約 3,290 token のカスタマーサポートマニュアルを冒頭に置き、連続して 4 つの質問をしたところ、4 回目で 3,072 個のキャッシュ token がヒットし、その回の費用は約 $0.001 から $0.00013 に下がりました。どれだけヒットしたかは usage の input_tokens_details.cached_tokens で確認できます。
パラメータ表(Responses)
| フィールド | 必須 | 値 | 説明 |
|---|---|---|---|
model |
はい | gpt-6.1-terra |
|
input |
はい | 配列 | メッセージ項目。文字列を渡すと 400 が返る |
stream |
はい | true |
false を渡すと 400 が返る |
store |
いいえ | false |
会話履歴はクライアントが保存し、毎ラウンド再送する |
reasoning.effort |
いいえ | none / low / medium / high / xhigh / max | デフォルトは medium |
text.format |
いいえ | json_schema | 厳格な JSON |
tools、tool_choice |
いいえ | 関数定義 | ツール呼び出し |
prompt_cache_key |
いいえ | 文字列 | リクエストヘッダー session_id と組み合わせてキャッシュをヒット |
instructions |
いいえ | 文字列 | 回答への要求 |
temperature、top_p は調整できず、回答の長さ上限も設定できません。長さを制御したい場合はプロンプトに書いてください。
遭遇するエラー
| 原因 | ステータスコード | 返却内容 |
|---|---|---|
レベルが誤っている(例:"turbo") |
400 | reasoning.effort: is outside allowed values |
stream に false を渡した |
400 | stream: must be true |
input を渡していない |
400 | input: is required |
| 未知のフィールドが含まれている | 400 | request.zz: unregistered public parameter |
| モデル名が誤っている | 400 | model_not_found、request ID 付き |
| 生成失敗 | 200 | ストリームは response.failed、error.code は generation_service_unstable、課金なし、リトライでよい |
パラメータエラーは送信時に 400 が返り、生成されず、料金も発生しません。
本番投入前の注意
- タイムアウトを長めに設定:推論レベルが高く回答が長いリクエストでは、4 分以上かかって終了したケースもあります。クライアントのタイムアウトは少なくとも 10 分に設定してください。
- 失敗時はリトライ:
response.failedもネットワーク断も「数秒待ってからリトライ」として扱い、最大 2〜3 回リトライしてください。 - 入力を 272K 以内に抑える:超えるとリクエスト全体が長コンテキスト料金になり、費用がほぼ 2 倍になります。
- 長いプレフィックスにはキャッシュを使う:システムプロンプトやナレッジベースのような固定の冒頭には、
prompt_cache_keyとsession_idを設定してください。
よくある質問
OpenAI 公式 SDK は使えますか?
使えます。Chat Completions のリクエストとレスポンスの形式は OpenAI と同一で、base URL を https://api.hiapi.ai/v1 に、key を HiAPI key に変更すればよいだけです。
マルチターンの会話はどうやりますか?
store は必ず false で、サーバー側では会話を保存しません。毎ラウンド、必要な履歴メッセージを input にまとめて再送します。再送する部分は入力として課金されますが、キャッシュを併用すれば大半を節約できます。
どのような入力に対応していますか?
テキストと画像で、出力はテキストです。モデルページの Playground では一度に最大 4 枚の画像をアップロードでき、1 枚あたり 10 MB までです。
GPT-6.1 Sol とはどう使い分けますか?
Terra の料金は Sol の半分で、none レベルが追加されています。私たちのテストでは Sol の方が速く返しました。同じ問題での比較は GPT-6.1 Terra vs GPT-6.1 Sol を参照してください。
すぐ使えるシーンプロンプトは GPT-6.1 Terra プロンプト大全 を参照してください。上の curl をコピーして質問を自分のものに置き換え、最初の呼び出しを通してみましょう。コードを書きたくない場合はモデルページを開いてすぐに試せます。
関連記事
すべての記事を見る →-

チュートリアル
Recraft Creative Upscale 事例:風景と水彩のアップスケール
山小屋、湖、水彩の町のテクスチャ変化を確認し、完全な結果とプレビューを区別して、描き直された細部をチェックします。
-
チュートリアル
OpenAI API キーが無効:401、環境変数とプロジェクト設定の調査
OpenAI の 401、403、429 を区別し、環境変数、組織とプロジェクトの設定を確認し、読み取り専用リクエストで認証情報を検証します。
-

チュートリアル
Kling 4.0 プロンプト大全:6つのシーンをそのままコピーして動画を生成
EC商品、グルメ、旅行風景、日常のワンシーン、音声付きの空撮カット、イメージ・トゥ・ビデオ。各シーンに実写動画、完全なプロンプト、ワンクリックで自動入力されるリンクをご用意。