
Руководство
Руководство по подключению к API GPT-6.1 Terra: curl, Python и OpenAI SDK
Два способа подключения — Responses и Chat Completions: как писать запросы для уровней рассуждения, чтения изображений, строгого JSON, вызова инструментов и кэширования, а также типичные ошибки.

TL;DR
- GPT-6.1 Terra(
gpt-6.1-terra)— модель среднего уровня, выпущенная OpenAI 26 октября 2026 года; она умеет читать изображения, вызывать инструменты и строго выводить данные по JSON schema. Уже доступна на HiAPI: откройте страницу модели, чтобы попробовать онлайн; при регистрации начисляется до 2 000 кредитов ($1). - Цена: $0,25 за миллион входных токенов и $1,25 за миллион выходных. Короткий ответ (около 90 входных и 80 выходных токенов) стоит примерно $0,0001.
- Самый быстрый способ вызова:
POST https://api.hiapi.ai/v1/responses, передайтеinputмассивом,stream: true,store: false.
Что умеет GPT-6.1 Terra
- 6 уровней рассуждения: none, low, medium (по умолчанию), high, xhigh, max. Для пакетных задач рассуждение можно полностью отключить (none).
- Чтение изображений: текст и изображения передаются в одном сообщении, на выходе получается текст.
- Строгий JSON: задайте JSON schema — возвращаемые поля и типы будут полностью соответствовать схеме.
- Вызов инструментов: модель решает, какую функцию вызвать и с какими аргументами; вы выполняете её и возвращаете результат, после чего модель пишет финальный ответ.
Контекст 1,05 млн токенов (до 922K на один вход), максимальный вывод 128K, знания актуальны по июнь 2026 года.
Для изображения товара ниже вместе со схемой данных о размещении Terra за 10 секунд вернула такой JSON:
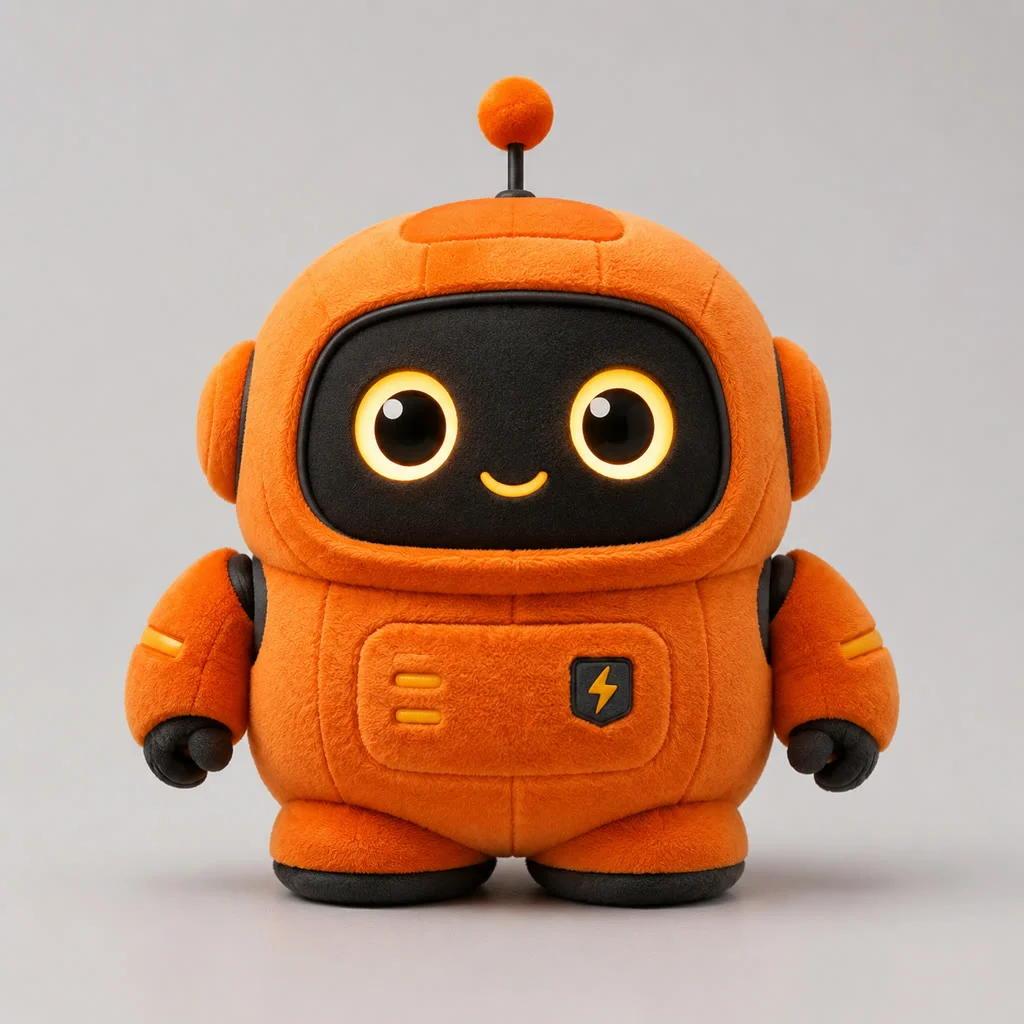
{"product_name":"Оранжевая плюшевая игрушка-робот","category":"Плюшевые игрушки","material":null,"main_color":"Оранжевый","selling_points":["Дизайн в виде робота, милый внешний вид","Оранжевый корпус с чёрными деталями, яркая цветовая гамма","Округлая объёмная форма, подходит как украшение или игрушка-компаньон"],"target_buyer":null}
gpt-6.1-terra, medium, 438 входных / 163 выходных токена, $0,0003. В промпте требовалось «для полей, которые не видны, указать null», поэтому материал и целевая аудитория вернулись как null.
Как выбрать между двумя интерфейсами
| Responses (по умолчанию) | Chat Completions | |
|---|---|---|
| Адрес | POST /v1/responses |
POST /v1/chat/completions |
| Потоковый режим | Обязателен stream: true |
Потоковый и непотоковый |
| Поле уровня рассуждения | reasoning.effort |
reasoning_effort |
| Поле строгого JSON | text.format |
response_format |
| Подходит для | Новых проектов, чтения изображений и вызова инструментов | Существующего кода OpenAI Chat со сменой base URL |
Оба интерфейса используют https://api.hiapi.ai и один и тот же ключ HiAPI.
Два пути начала работы
Браузер (без кода)
- Откройте страницу модели GPT-6.1 Terra и войдите.
- В Playground выберите уровень рассуждения, введите вопрос или вставьте изображение.
- Ответ отображается потоково; после завершения показываются расход токенов, время выполнения и ориентировочная стоимость.
API
- Создайте ключ на странице API Keys в консоли и сохраните его в переменную окружения
HIAPI_API_KEY. - Скопируйте приведённый ниже curl и выполните первый вызов.
- Перейдите на Python и читайте потоковый результат по типам событий.
curl: первый вызов
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Объясни в трёх предложениях, что такое идемпотентность."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
Возвращается SSE-поток со следующими событиями по порядку:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (много раз)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
Текст ответа находится в delta события response.output_text.delta, расход токенов — в response.usage последнего события response.completed. В потоке могут появляться и другие типы событий; распределяйте их по type, а незнакомые просто пропускайте.
Python: потоковое чтение
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Объясни в трёх предложениях, что такое идемпотентность."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # читаем побайтово, декодируем в UTF-8 самостоятельно
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Две типичные ловушки:
- Не используйте
iter_lines(decode_unicode=True). Строкаresponse.completedчасто превышает 8 КБ, и requests без знания кодировки декодирует её как latin-1, из-за чего китайский текст становится мусором. Читайте побайтово и затем декодируйте в UTF-8. - Ошибка также возвращается с HTTP 200. При неудачной генерации в потоке приходит
response.failed, usage пуст, плата не списывается. Нужно отдельно обработать это и повторить попытку.
Chat Completions: замена в существующем коде
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Объясни в трёх предложениях, что такое идемпотентность."}],
    "reasoning_effort": "low"
  }'
С официальным Python SDK OpenAI достаточно изменить base_url и ключ:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Объясни в трёх предложениях, что такое идемпотентность."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
В непотоковом режиме сразу возвращается полный choices[0].message.content. Добавьте "stream": true — получите стандартный поток чанков, завершающийся data: [DONE]. С одним и тем же промптом для ответа службы поддержки в непотоковом режиме полный ответ получен за 33 секунды; в потоковом первый символ появился через 2,5 секунды, а завершение — через 4,5 секунды. Для пользовательских сценариев используйте потоковый режим.
Уровни рассуждения
В Responses пишите "reasoning": {"effort": "none"}, в Chat — "reasoning_effort": "none". По умолчанию medium. С одним и тем же промптом для декомпозиции требований medium стоит $0,002–0,004 за вызов, max — $0,012–0,014 за вызов. Токены и время выполнения для каждого уровня см. в цены API GPT-6.1 Terra.
Чтение изображений
Добавьте в content того же сообщения элемент input_image; изображение задаётся публичным HTTPS-адресом:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Опиши основной объект изображения и две видимые детали."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
Строгий JSON
Добавьте в тело запроса text.format (в Chat — response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
В строгом режиме каждое свойство должно быть указано в required; для полей, которые могут быть пустыми, используйте ["string", "null"]. Возвращаемый текст — это JSON, который можно сразу передать в json.loads.
Вызов инструментов: два раунда
В первом раунде передайте tools в запросе:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
На вопрос «Где заказ HX-20481?» модель не пишет текст, а возвращает только function_call: name — get_order_status, arguments — {"order_id":"HX-20481"}, а также call_id.
Во втором раунде в input последовательно положите: исходное сообщение пользователя, возвращённый в прошлом раунде function_call и результат выполнения вашей функции:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
На основании этого модель отвечает: «Заказ HX-20481 в пути, доставку осуществляет SF Express… ожидаемая доставка: 30 октября 2026 года». Оба раунда вместе стоят около $0,00016. При возврате используйте call_id, а не id, начинающийся с fc_.
Попадание в кэш
Передайте prompt_cache_key в теле и session_id с тем же значением в заголовке запроса, а начало промпта оставьте дословно неизменным:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Мы использовали руководство службы поддержки объёмом около 3 290 токенов в качестве начала и задали 4 вопроса подряд; на 4-й раз в кэш попало 3 072 токена, и стоимость этого вызова снизилась с примерно $0,001 до $0,00013. Сколько попало в кэш, смотрите в input_tokens_details.cached_tokens в usage.
Таблица параметров (Responses)
| Поле | Обязательно | Значения | Описание |
|---|---|---|---|
model |
Да | gpt-6.1-terra |
|
input |
Да | Массив | Элементы сообщений; передача строки вернёт 400 |
stream |
Да | true |
Передача false вернёт 400 |
store |
Нет | false |
Историю диалога хранит клиент и повторяет каждый раунд |
reasoning.effort |
Нет | none / low / medium / high / xhigh / max | По умолчанию medium |
text.format |
Нет | json_schema | Строгий JSON |
tools, tool_choice |
Нет | Определения функций | Вызов инструментов |
prompt_cache_key |
Нет | Строка | Вместе с заголовком session_id обеспечивает попадание в кэш |
instructions |
Нет | Строка | Требования к ответу |
temperature и top_p не настраиваются, максимальную длину ответа также нельзя задать; если нужно контролировать длину, укажите это в промпте.
Ошибки, с которыми вы столкнётесь
| Причина | Код состояния | Ответ |
|---|---|---|
Неверный уровень (например, "turbo") |
400 | reasoning.effort: is outside allowed values |
stream передан как false |
400 | stream: must be true |
Не передан input |
400 | input: is required |
| Лишнее незнакомое поле | 400 | request.zz: unregistered public parameter |
| Неверное имя модели | 400 | model_not_found с request ID |
| Ошибка генерации | 200 | В потоке response.failed, error.code равен generation_service_unstable, плата не списывается, повторите попытку |
Ошибки параметров возвращаются с кодом 400 сразу при отправке, генерация не выполняется и деньги не списываются.
Внимание перед запуском в продакшен
- Установите тайм-аут подольше: для запросов с высоким уровнем рассуждения и длинным ответом мы встречали завершение через 4 минуты и более. Установите тайм-аут клиента не менее 10 минут.
- Повторяйте при ошибках:
response.failedи обрывы сети обрабатывайте как «подождать несколько секунд и повторить», максимум 2–3 раза. - Держите вход в пределах 272K: при превышении весь запрос тарифицируется по цене длинного контекста, и стоимость почти удваивается.
- Используйте кэш для длинных префиксов: для фиксированного начала вроде системных подсказок и базы знаний настройте
prompt_cache_keyиsession_id.
Частые вопросы
Можно ли использовать официальный SDK OpenAI?
Да. Формат запросов и ответов Chat Completions совпадает с OpenAI: измените base URL на https://api.hiapi.ai/v1 и замените ключ на ключ HiAPI.
Как реализовать многораундовый диалог?
store должен быть false, сервер не сохраняет диалог. Каждый раунд передавайте нужные исторические сообщения вместе в input повторно; повторно переданная часть тарифицируется как вход, и с кэшем можно сэкономить большую часть.
Какие входные данные поддерживаются?
Текст и изображения, на выходе — текст. В Playground на странице модели можно за один раз загрузить до 4 изображений, каждое не более 10 МБ.
Как выбрать между GPT-6.1 Terra и GPT-6.1 Sol?
Terra стоит вдвое меньше Sol и имеет дополнительный уровень none; в наших тестах Sol отвечает быстрее. Сравнение на одинаковых задачах см. в GPT-6.1 Terra vs GPT-6.1 Sol.
Готовые промпты для типовых сценариев см. в сборник промптов GPT-6.1 Terra. Скопируйте curl выше, замените вопрос на свой и выполните первый вызов; если не хотите писать код, откройте страницу модели и попробуйте сразу.
Похожие статьи
Все статьи →-

Руководство
Примеры Recraft Creative Upscale: увеличение пейзажей и акварели
Посмотрите изменения текстур деревянного дома, озера и акварельного городка, отличите полный результат от предпросмотра и проверьте перерисованные детали.
-
Руководство
Недействительный ключ OpenAI API: 401, переменные окружения и проверка конфигурации проекта
Различайте OpenAI 401, 403 и 429, проверяйте переменные окружения, настройки организации и проекта, а также проверяйте учётные данные запросом только на чтение.
-

Руководство
Kling 4.0: полный набор промптов — 6 сценариев, которые можно скопировать и сразу получить видео
Товары для электронной коммерции, еда, пейзажи путешествий, бытовые зарисовки, пустые кадры со звуком и видео из изображения — для каждого сценария есть реальное готовое видео, полный промпт и ссылка с автозаполнением.