
Tutoriale
Guida all'integrazione delle API di GPT-6.1 Terra: curl, Python e OpenAI SDK
Due modi di integrare: Responses e Chat Completions, con la sintassi delle richieste per livelli di ragionamento, lettura di immagini, JSON rigoroso, chiamata di strumenti e cache, oltre agli errori più comuni.

TL;DR
- GPT-6.1 Terra (
gpt-6.1-terra) è il modello di fascia media rilasciato da OpenAI il 26 ottobre 2026: legge immagini, chiama strumenti e produce output rigorosamente conforme a uno schema JSON. È già disponibile su HiAPI: apri la pagina del modello per provarlo online; registrandoti ricevi fino a 2.000 crediti ($1). - Prezzo: $0.25 ogni milione di token in input, $1.25 in output. Una risposta breve (circa 90 token in input e 80 in output) costa circa $0.0001.
- Il modo più rapido per chiamarlo:
POST https://api.hiapi.ai/v1/responses, passando un array ininput, constream: trueestore: false.
Cosa sa fare GPT-6.1 Terra
- 6 livelli di ragionamento: none, low, medium (predefinito), high, xhigh, max. Per le attività in batch puoi disattivare del tutto il ragionamento (none).
- Lettura di immagini: testo e immagini nello stesso messaggio, con output testuale.
- JSON rigoroso: fornisci uno schema JSON e i campi e i tipi restituiti seguiranno esattamente lo schema.
- Chiamata di strumenti: il modello decide quale funzione chiamare e con quali parametri; tu la esegui, gli restituisci il risultato e lui scrive la risposta finale.
Contesto di 1,05M token (massimo 922K per singolo input), output massimo 128K, conoscenza aggiornata a giugno 2026.
Con l'immagine di prodotto qui sotto e uno schema per le informazioni di pubblicazione, Terra ha restituito questo JSON in 10 secondi:
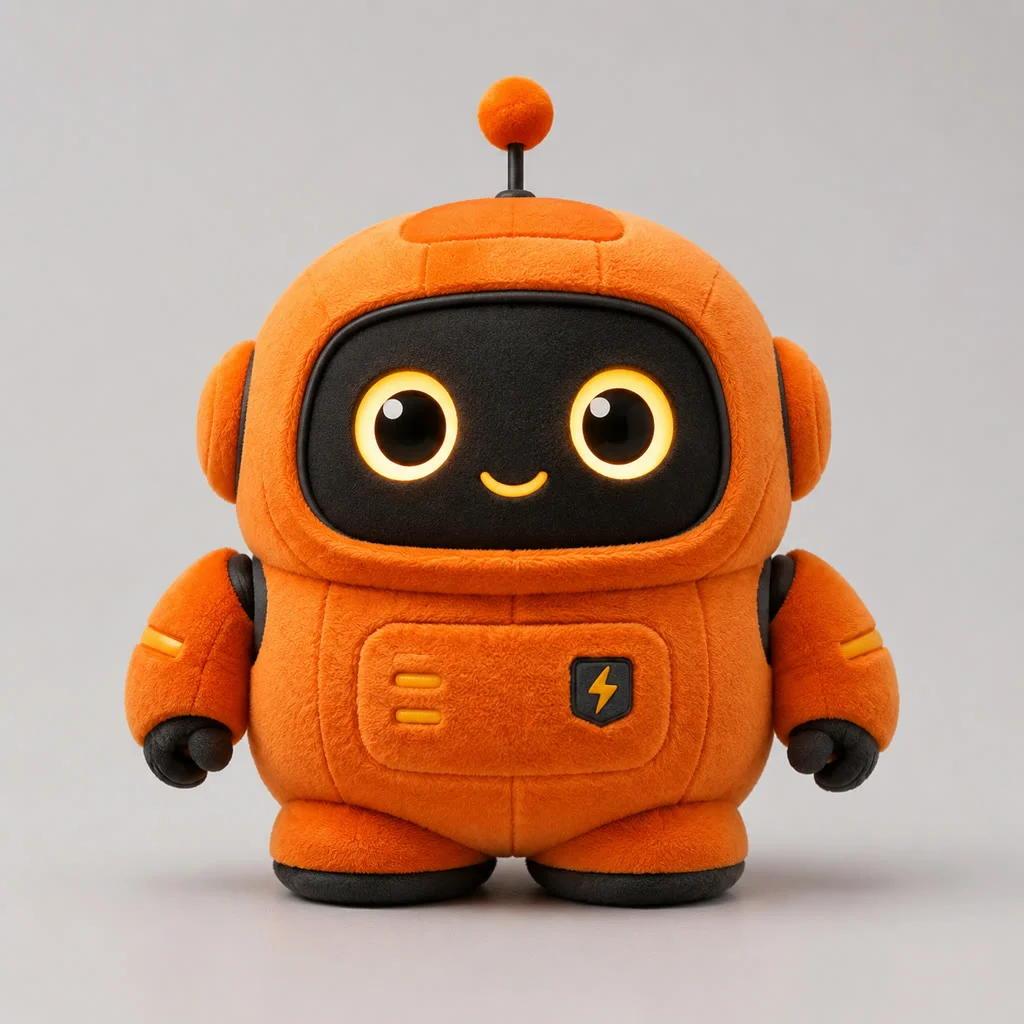
{"product_name":"Peluche robot arancione","category":"Peluche","material":null,"main_color":"Arancione","selling_points":["Design a forma di robot dall'aspetto grazioso","Corpo arancione con dettagli neri, abbinamento di colori accattivante","Forma arrotondata e tridimensionale, adatta come oggetto decorativo o peluche da compagnia"],"target_buyer":null}
gpt-6.1-terra, medium, 438 token in input / 163 in output, $0.0003. Il prompt richiedeva «compila con null i campi non deducibili», quindi materiale e pubblico di riferimento sono tornati null.
Quale delle due API scegliere
| Responses (predefinita) | Chat Completions | |
|---|---|---|
| Endpoint | POST /v1/responses |
POST /v1/chat/completions |
| Streaming | obbligatorio stream: true |
streaming e non streaming supportati |
| Campo del livello di ragionamento | reasoning.effort |
reasoning_effort |
| Campo per JSON rigoroso | text.format |
response_format |
| Adatta a | nuovi progetti, lettura di immagini e chiamata di strumenti | codice OpenAI Chat esistente da usare cambiando solo il base URL |
Entrambe le API usano https://api.hiapi.ai e la stessa chiave HiAPI.
Due percorsi per iniziare
Nel browser (senza scrivere codice)
- Apri la pagina del modello GPT-6.1 Terra e accedi.
- Nel Playground scegli il livello di ragionamento, inserisci una domanda o incolla un'immagine.
- La risposta appare in streaming; al termine vengono mostrati l'utilizzo dei token, il tempo impiegato e il costo stimato.
API
- Crea una chiave nella pagina API Keys della console e salvala nella variabile d'ambiente
HIAPI_API_KEY. - Copia il curl qui sotto per effettuare la prima chiamata.
- Passa a Python e leggi i risultati in streaming in base al tipo di evento.
curl: la prima chiamata
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Spiega in tre frasi che cos'è l'idempotenza."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
La risposta è un flusso SSE con questi eventi in sequenza:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (many times)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
Il testo è nel delta di response.output_text.delta, mentre l'utilizzo dei token è in response.usage dell'ultimo response.completed. Nel flusso possono comparire altri tipi di evento: distribuisci in base a type e ignora quelli che non conosci.
Python: lettura in streaming
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Spiega in tre frasi che cos'è l'idempotenza."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # read byte by byte and decode as UTF-8 yourself
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Due errori facili da commettere:
- Non usare
iter_lines(decode_unicode=True). La riga diresponse.completedsupera spesso gli 8KB e requests, quando non conosce la codifica, decodifica in latin-1, trasformando i caratteri cinesi in testo illeggibile. Leggi per byte e poi decodifica in UTF-8. - Anche i fallimenti restituiscono HTTP 200. Quando la generazione fallisce, nel flusso arriva
response.failed, usage è vuoto e non viene addebitato nulla. Va gestito separatamente, poi ritenta.
Chat Completions: riutilizza il codice esistente
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Spiega in tre frasi che cos'è l'idempotenza."}],
    "reasoning_effort": "low"
  }'
Con l'SDK Python ufficiale di OpenAI basta cambiare base_url e chiave:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Spiega in tre frasi che cos'è l'idempotenza."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
In modalità non streaming restituisce direttamente il contenuto completo in choices[0].message.content. Aggiungendo "stream": true si ottiene un flusso di chunk standard, che termina con data: [DONE]. Con lo stesso prompt di risposta al cliente, in modalità non streaming abbiamo ottenuto la risposta completa in 33 secondi; in streaming il primo carattere è arrivato dopo 2,5 secondi e la risposta è terminata in 4,5 secondi. Per le interfacce rivolte all'utente usa lo streaming.
Livelli di ragionamento
In Responses scrivi "reasoning": {"effort": "none"}, in Chat scrivi "reasoning_effort": "none". Il valore predefinito è medium. Con lo stesso prompt di scomposizione dei requisiti, medium costa $0.002–0.004 a chiamata, max $0.012–0.014. Token e tempi di ogni livello sono in Prezzi delle API di GPT-6.1 Terra.
Lettura di immagini
Aggiungi un elemento input_image nel content dello stesso messaggio, usando un URL HTTPS pubblico per l'immagine:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Descrivi il soggetto dell'immagine e due dettagli visibili."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
JSON rigoroso
Aggiungi text.format nel corpo della richiesta (in Chat usa response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
In modalità strict ogni proprietà deve essere inclusa in required; per i campi che possono essere vuoti usa ["string", "null"]. Il corpo restituito è un JSON che puoi passare direttamente a json.loads.
Chiamata di strumenti: due turni
Nel primo turno includi tools nella richiesta:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
Chiedendo «Dov'è l'ordine HX-20481?», il modello non scrive testo, ma restituisce solo un function_call: name è get_order_status, arguments è {"order_id":"HX-20481"}, insieme a un call_id.
Nel secondo turno, metti in input in ordine: il messaggio utente originale, il function_call restituito nel turno precedente e il risultato dell'esecuzione della tua funzione:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
Il modello risponde di conseguenza: «L'ordine HX-20481 è in transito, spedito da SF Express… consegna prevista: 30 ottobre 2026». I due turni costano complessivamente circa $0.00016. Quando restituisci il risultato usa call_id, non l'id che inizia con fc_.
Colpire la cache
Passa prompt_cache_key nel body e session_id con lo stesso valore nell'header della richiesta, mantenendo invariata parola per parola l'inizio del prompt:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Abbiamo usato come prefisso un manuale di assistenza clienti di circa 3.290 token e posto 4 domande di seguito: alla quarta, 3.072 token di cache sono stati colpiti e il costo è sceso da circa $0.001 a $0.00013. Quanti token sono stati colpiti si vede in input_tokens_details.cached_tokens dentro usage.
Tabella dei parametri (Responses)
| Campo | Obbligatorio | Valori | Descrizione |
|---|---|---|---|
model |
Sì | gpt-6.1-terra |
|
input |
Sì | array | Elementi messaggio; passare una stringa restituisce 400 |
stream |
Sì | true |
Passare false restituisce 400 |
store |
No | false |
La cronologia della conversazione è salvata dal client e reinviata a ogni turno |
reasoning.effort |
No | none / low / medium / high / xhigh / max | Predefinito medium |
text.format |
No | json_schema | JSON rigoroso |
tools, tool_choice |
No | definizione di funzione | Chiamata di strumenti |
prompt_cache_key |
No | stringa | Da abbinare all'header session_id per colpire la cache |
instructions |
No | stringa | Requisiti per la risposta |
temperature e top_p non sono regolabili, e non si può impostare un limite alla lunghezza della risposta: se devi controllarla, scrivilo nel prompt.
Errori che incontrerai
| Causa | Codice di stato | Risposta |
|---|---|---|
Livello errato (es. "turbo") |
400 | reasoning.effort: is outside allowed values |
stream impostato a false |
400 | stream: must be true |
input mancante |
400 | input: is required |
| Campo sconosciuto in più | 400 | request.zz: unregistered public parameter |
| Nome del modello errato | 400 | model_not_found, con request ID |
| Generazione fallita | 200 | Nel flusso compare response.failed, error.code è generation_service_unstable, nessun addebito, basta ritentare |
Gli errori nei parametri restituiscono 400 al momento dell'invio: non avviene alcuna generazione e non viene addebitato nulla.
Da tenere presente prima della messa in produzione
- Imposta timeout più lunghi: con livelli di ragionamento alti e risposte lunghe ci sono capitate richieste che terminavano dopo più di 4 minuti. Imposta sul client un timeout di almeno 10 minuti.
- Ritenta in caso di fallimento: gestisci
response.failede le interruzioni di rete con «aspetta qualche secondo e ritenta», per un massimo di 2–3 tentativi. - Mantieni l'input sotto 272K: superata questa soglia, l'intera richiesta viene fatturata al prezzo del contesto lungo, quasi raddoppiando il costo.
- Usa la cache per i prefissi lunghi: per elementi fissi iniziali come prompt di sistema e basi di conoscenza, configura
prompt_cache_keyesession_id.
Domande frequenti
Posso usare l'SDK ufficiale di OpenAI?
Sì. Il formato delle richieste e delle risposte di Chat Completions è identico a quello di OpenAI: basta cambiare il base URL in https://api.hiapi.ai/v1 e la chiave con quella di HiAPI.
Come si gestisce una conversazione multi-turno?
store deve essere false: il server non salva la conversazione. A ogni turno rimanda in input i messaggi della cronologia necessari; la parte reinviata viene fatturata come input, e con la cache puoi risparmiare gran parte del costo.
Quali input sono supportati?
Testo e immagini, con output testuale. Nel Playground della pagina del modello puoi caricare al massimo 4 immagini per volta, ciascuna non superiore a 10 MB.
Come scegliere tra GPT-6.1 Terra e GPT-6.1 Sol?
Terra costa la metà di Sol e ha un livello in più, none; nei nostri test Sol risponde più rapidamente. Il confronto sullo stesso compito è in GPT-6.1 Terra vs GPT-6.1 Sol.
Prompt pronti per scenari concreti sono in Raccolta di prompt per GPT-6.1 Terra. Copia il curl qui sopra, sostituisci la domanda con la tua e fai la prima chiamata; se preferisci non scrivere codice, apri la pagina del modello e provalo direttamente.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Casi di Recraft Creative Upscale: paesaggi e acquerelli ingranditi
Osserva le variazioni di texture su baita, lago e cittadina ad acquerello, distingui il risultato completo dall'anteprima e controlla i dettagli ridisegnati.
-
Tutoriale
Chiave API OpenAI non valida: 401, variabili d'ambiente e verifica della configurazione di progetto
Distingui gli errori 401, 403 e 429 di OpenAI, controlla variabili d'ambiente, impostazioni di organizzazione e progetto e verifica le credenziali con una richiesta in sola lettura.
-

Tutoriale
Raccolta completa di prompt per Kling 4.0: 6 scene da cui copiare direttamente per creare video
Prodotti e-commerce, cibo, paesaggi di viaggio, momenti di vita quotidiana, b-roll con audio e image-to-video: ogni scena ha un video reale, il prompt completo e un link con compilazione automatica con un clic.