
Tutorial
Seedance 2.0 micro parkour: cinco prompts de planos para um personagem em escala fixa de 1:15
Uma dublê do tamanho da palma da mão faz parkour livremente em uma loja gigante de equipamentos digitais, em cinco planos cuidadosamente coreografados. Este artigo decompõe o prompt original take a take e inclui a chamada /v1/tasks para reproduzir o efeito.
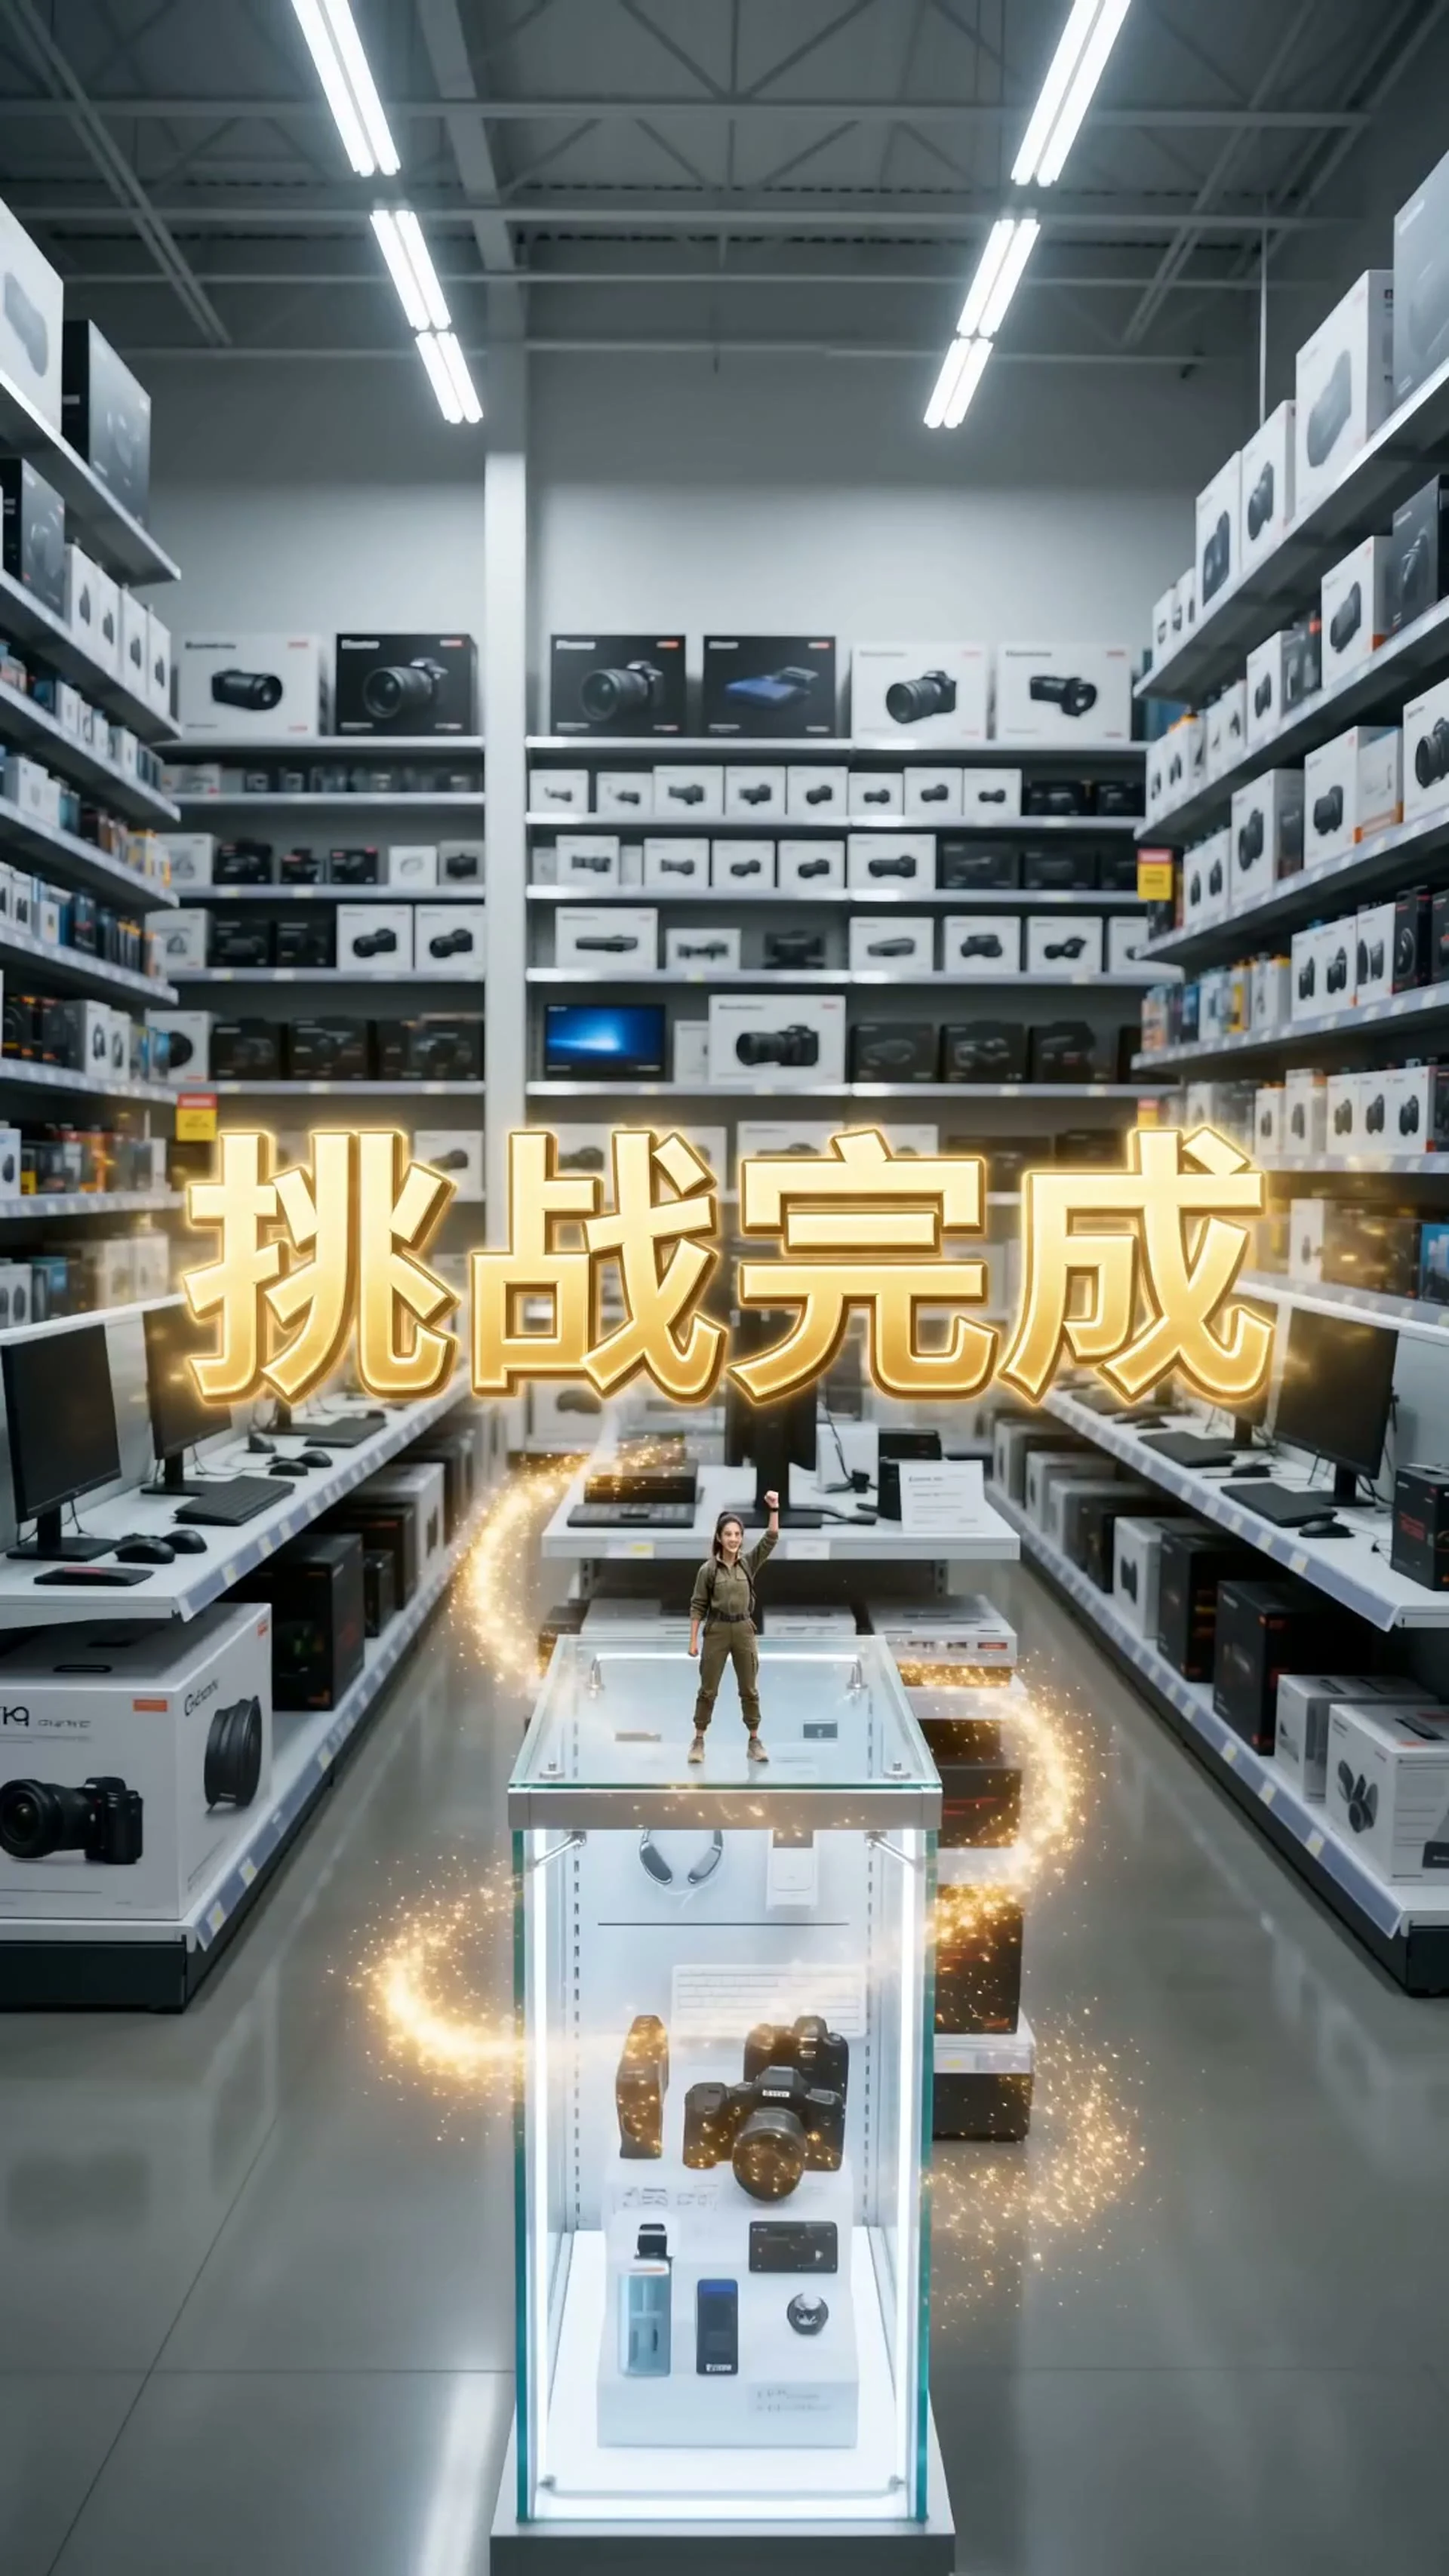
A mulher neste vídeo tem o tamanho da palma da mão. Ela faz parkour livremente em uma loja de equipamentos digitais — salta de um saco de teclas de teclado, corre sobre uma garrafa de limpa-telas, desliza por uma tirolesa feita com a alça de uma cesta de compras sobre caixas de fones de ouvido, surfa em uma lata rolante de ar comprimido e finalmente aterrissa firme no topo de uma vitrine de vidro, ergue o punho e, atrás dela, grandes caracteres chineses dourados piscam "Desafio concluído". Cinco planos, uma única geração de 15 segundos no Seedance 2.0, com o mesmo personagem em escala 1:15 em cada frame. Este artigo é o prompt original que gerou esse vídeo, com uma decomposição parte por parte do que cada trecho realmente faz.
A consistência entre múltiplos planos é o problema que a maioria dos prompts de "pessoa em miniatura" nunca resolve. Fazer um personagem pequeno executar várias ações geralmente resulta, a cada corte, em um rosto diferente, uma roupa diferente ou uma proporção diferente. Este prompt evita esse problema escrevendo os 15 segundos inteiros como uma única lista de planos — uma ficha de personagem, seguida de cinco batidas numeradas, cada uma com seu próprio movimento de câmera e design de som — em vez de uma descrição vaga de cena esperando que o modelo mantenha a continuidade por conta própria.
Prompt completo
Estilo: efeito de pessoa em miniatura, filmagem realista em locação, fotografia macro cinematográfica, profundidade de campo ultra rasa, loja moderna e iluminada de equipamentos digitais, iluminação fluorescente realista, 8K ultra detalhado, vertical 9:16, estilo de vídeo curto viral e dinâmico.

Duração: 15 segundos.

Cenário: uma enorme loja moderna de equipamentos digitais, repleta de prateleiras altíssimas com sacos coloridos de teclas de teclado, caixas de câmera, caixas de lente, caixas de fones de ouvido, teclados, mouses, limpa-telas, latas de ar comprimido, cartões de memória, monitores, cestas de compras e etiquetas de preço penduradas. Do ponto de vista de uma mulher do tamanho da palma da mão, tudo parece gigantesco.

Personagem: uma mulher atlética em miniatura (escala 1:15), com aparência consistente do início ao fim: jaqueta leve de aventura, calça cargo, tênis, mochila multifuncional, com rosto, cabelo, proporções e tamanho idênticos em cada plano.

00:00–00:03 — Balanço na prateleira de equipamentos digitais

Ela está em pé sobre um enorme saco colorido de teclas de teclado, corre e salta em direção a uma etiqueta de preço pendurada, agarra-a com as duas mãos, balança-se pelo corredor da prateleira e se lança para a prateleira seguinte. A etiqueta balança atrás dela.

Câmera: acompanhamento macro em ângulo baixo.
Som: farfalhar de plástico, passos de pés pequenos, vento assobiando, som da etiqueta balançando.

00:03–00:06 — Parkour nas tampas

Ela aterrissa sobre uma enorme garrafa de limpa-telas e faz parkour nas tampas coloridas. Uma garrafa balança sob ela; ela recupera o equilíbrio e dá um rolamento para frente até a prateleira seguinte.

Câmera: acompanhamento macro lateral rápido.
Som: passos, rangido da garrafa, líquido balançando, aterrissagem dura.

00:06–00:09 — Tirolesa até a cesta de compras

Ela agarra uma corda promocional pendurada e desliza sobre caixas de câmera, caixas de fones de ouvido e sacos de teclas. Solta no momento exato e aterrissa dentro de uma cesta de compras em movimento, cercada por enormes caixas de fones de ouvido, embalagens de cartões de memória e kits de limpeza de lentes.

Câmera: transição de ângulo aéreo para ângulo baixo.
Som: assobio da tirolesa, vento, rodas da cesta, impacto.

00:09–00:12 — Lata de ar comprimido descontrolada

Uma enorme lata metálica de ar comprimido rola dentro da cesta. Ela salta em cima dela, mantém o equilíbrio como um surfista e a monta atravessando o piso liso, desviando por pouco de sapatos de compradores, cestas e embalagens de acessórios digitais espalhadas.

Câmera: acompanhamento macro no nível do chão, bem baixo.
Som: rolagem metálica, vento, ambiente sonoro da loja.

00:12–00:15 — Final vitorioso

Usando a lata de ar comprimido como rampa de lançamento, ela salta em direção à maçaneta da vitrine de vidro, balança-se para cima e fica no topo da vitrine em pose triunfal. A enorme loja de equipamentos digitais se estende atrás dela, enquanto aparecem partículas brilhantes e grandes caracteres chineses dourados exibem:

"Desafio concluído"

Ela ergue um punho enquanto a câmera se afasta lentamente, enfatizando sua escala minúscula.

Câmera: afastamento cinematográfico.
Som: assobio do salto, agarre metálico, sinos de vitória, brilho, ambiente sonoro da loja.

Requisitos visuais: manter a proporção em miniatura consistente de 1:15, física realista, movimento contínuo e fluido, embalagens realistas, reflexos reais, profundidade de campo macro cinematográfica e identidade consistente do personagem. Sem animação, desenho animado, narração, legendas, mudanças de figurino ou proporções inconsistentes.
O prompt foi escrito em chinês, e o Seedance 2.0 o renderiza sem qualquer etapa de tradução — o modelo não se importa com o idioma do prompt. A seguir, o que cada bloco faz, na ordem.
1. Fixar o personagem antes do primeiro plano
Personagem: uma mulher atlética em miniatura (escala 1:15), com aparência consistente do início ao fim: jaqueta leve de aventura, calça cargo, tênis, mochila multifuncional, com rosto, cabelo, proporções e tamanho idênticos em cada plano.
("Personagem: uma mulher atlética em miniatura, escala 1:15, aparência consistente em todo o vídeo — jaqueta leve de aventura, calça cargo, tênis, mochila multifuncional, o mesmo rosto, cabelo, proporções e tamanho em cada plano.")
Este trecho aparece antes de qualquer descrição de cena e faz apenas uma coisa: entrega ao modelo uma única ficha de personagem para reutilizar durante os quinze segundos seguintes, em vez de reinventá-la a cada batida. A proporção é declarada explicitamente como um número ("1:15"), e não como um vago "tiny" ou "miniature", e o figurino é específico o suficiente para que o modelo não tenha margem para improvisar entre planos. A frase final de requisitos visuais repete a mesma restrição por outro caminho — "identidade consistente do personagem... sem mudanças de figurino ou proporções inconsistentes" — de modo que a regra é declarada no início e no fim do prompt.
2. Construir o mundo com objetos cotidianos ampliados
Cenário: uma enorme loja moderna de equipamentos digitais, repleta de prateleiras altíssimas com sacos coloridos de teclas de teclado, caixas de câmera, caixas de lente, caixas de fones de ouvido, teclados, mouses, limpa-telas, latas de ar comprimido, cartões de memória, monitores, cestas de compras e etiquetas de preço penduradas.
Uma loja de equipamentos digitais é um ótimo cenário justamente porque não há nada de exótico nela — sacos de teclas, garrafas de limpa-telas, latas de ar comprimido, cestas de compras. Na escala 1:15, a tralha comum do varejo se transforma em uma academia de parkour: etiquetas de preço viram cordas de balanço, tampas de garrafa viram traves de equilíbrio, latas rolantes viram pranchas de surfe. O truque do "objeto cotidiano gigante" realiza o trabalho visual que cenários mais fantásticos não conseguiriam — o humor e a sensação de escala vêm de o espectador reconhecer o que aquele objeto realmente é.
3. Escrever os cinco planos como uma lista de filmagem de dublês
Em vez de uma indicação contínua de câmera, o prompt divide os 15 segundos em cinco batidas rotuladas, cada uma com seu carimbo de tempo, seu próprio movimento de câmera e seu próprio design de som:
| Batida | Ação | Câmera | Áudio |
|---|---|---|---|
| 00:00–00:03 | Balançar-se a partir de uma etiqueta de preço pendurada entre as prateleiras | Acompanhamento macro em ângulo baixo | Farfalhar de plástico, passos pequenos, vento assobiando, som da etiqueta balançando |
| 00:03–00:06 | Parkour sobre tampas que balançam | Acompanhamento macro lateral rápido | Passos, rangido da garrafa, líquido balançando, aterrissagem dura |
| 00:06–00:09 | Tirolesa sobre as caixas e queda em uma cesta de compras em movimento | Transição de ângulo aéreo para ângulo baixo | Assobio da tirolesa, vento, rodas da cesta, impacto |
| 00:09–00:12 | Surfar em uma lata de ar comprimido rolando pelo chão | Acompanhamento macro no nível do chão, bem baixo | Rolagem metálica, vento, ambiente sonoro da loja |
| 00:12–00:15 | Lançar-se da lata até a vitrine para o final | Afastamento cinematográfico | Assobio do salto, agarre metálico, sinos de vitória, brilho, ambiente sonoro da loja |
Cada batida se encadeia fisicamente na próxima — ela aterrissa do balanço direto no parkour das tampas, rola do parkour das tampas para a tirolesa, cai da tirolesa na lata rolante e se lança da lata para o final. É esse encadeamento que faz cinco planos separados serem lidos como uma perseguição contínua, e não como cinco trechos desconexos colados.
4. Escrever o final como recompensa, não apenas mais uma batida
Usando a lata de ar comprimido rolante como rampa de lançamento, ela salta em direção à maçaneta da vitrine de vidro, balança-se para cima e fica no topo da vitrine em pose triunfal... enquanto aparecem partículas brilhantes e grandes caracteres chineses dourados exibem: "Desafio concluído"
As quatro primeiras batidas são impulso e perigo; só a quinta fecha o conjunto. Dar ao final uma recompensa própria — aterrissagem firme, câmera se afastando, partículas brilhantes, recompensa em texto na tela — é exatamente o que transforma um parkour em uma história completa, e não em um loop que pode terminar em qualquer batida. É o mesmo princípio de escrever explicitamente o destino em um voo em plano único (veja nossa decomposição do voo em primeira pessoa em plano único do Seedance 2.0): sequências de múltiplas batidas precisam ter o final escrito no prompt, ou então simplesmente param.
5. Fechar com uma cláusula rígida de consistência
Requisitos visuais: manter a proporção em miniatura consistente de 1:15, física realista, movimento contínuo e fluido, embalagens realistas, reflexos reais, profundidade de campo macro cinematográfica e identidade consistente do personagem. Sem animação, desenho animado, narração, legendas, mudanças de figurino ou proporções inconsistentes.
A última linha é uma lista de verificação, não texto decorativo: proporção consistente de 1:15, física realista, movimento contínuo e fluido, embalagens realistas, reflexos reais, profundidade de campo macro cinematográfica, identidade consistente — e então uma breve lista negra dos modos de falha que realmente aparecem em prompts de personagens em miniatura (renderização de animação/desenho animado, narração, legendas gravadas na imagem, deriva de figurino, deriva de proporção). Cada item da lista corresponde a algo já declarado antes no prompt; esta seção apenas o torna não negociável.
Executar na hiapi
Uma chamada de tarefa assíncrona e depois sondagem para obter o resultado:
# 1. Create the task
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "Estilo: efeito de pessoa em miniatura, filmagem realista em locação... (o prompt completo acima)",
      "aspect_ratio": "9:16",
      "duration": 15,
      "resolution": "1080p",
      "generate_audio": true
    }
  }'

# 2. Poll until status = success, then download output[0].url
curl https://api.hiapi.ai/v1/tasks/$TASK_ID \
  -H "Authorization: Bearer $HIAPI_TOKEN"
Duas dicas práticas:
- O custo é cobrado por segundo, por faixa de resolução. Em outubro de 2026: 480p custa US$ 0,136/s, 720p custa US$ 0,293/s, 1080p custa US$ 0,729/s e 4k custa US$ 1,486/s. Um clipe de 15 segundos como este sai por cerca de US$ 2,04 em 480p, US$ 4,40 em 720p, US$ 10,94 em 1080p e US$ 22,29 em 4k — o mesmo prompt, com a faixa escolhida conforme o uso do plano. Consulte os preços atuais na página de preços e na página do modelo Seedance 2.0.
- Vertical e horizontal funcionam da mesma forma. Este clipe é renderizado com
aspect_ratio: "9:16"em vez do habitual16:9— o preço por segundo e o limite de duração não mudam com a orientação, apenas a forma do quadro. Para a tabela completa de parâmetros (primeiro frame/último frame, imagens de referência, outras proporções), veja o guia da API do Seedance 2.0.
Perguntas frequentes
O Seedance 2.0 realmente consegue manter o mesmo personagem em cinco acrobacias diferentes em uma única geração?
Sim, em uma única geração — é exatamente disso que o prompt depende. A ficha do personagem ("escala 1:15, o mesmo rosto, cabelo, proporções e tamanho em cada plano") aparece antes de qualquer uma das cinco batidas, e a frase de requisitos visuais repete a mesma restrição no final. Remova qualquer uma das duas e a deriva de proporção/identidade entre planos será a falha mais comum.
O texto sobreposto "Desafio concluído" vem da mesma geração?
Sim — ele está escrito como elemento de cena na batida final ("grandes caracteres chineses dourados exibem: 'Desafio concluído'"), da mesma forma que as partículas brilhantes e os sinos de vitória. Nada no clipe acima foi composto em pós-produção.
O 9:16 vertical está disponível em todas as faixas de resolução?
O Seedance 2.0 suporta proporções verticais e horizontais nas mesmas faixas de resolução; o preço é cobrado por segundo de resolução, não por orientação. Antes de fixar o plano em um formato de quadro específico, consulte a página do modelo para ver a lista atual de proporções.
E se eu quiser mais de cinco batidas, ou mais de 15 segundos?
15 segundos é a duração máxima de uma única geração do modelo. Para sequências mais longas, planeje várias gerações de 15 segundos, incluindo em cada prompt o texto correspondente da ficha do personagem, ou consulte Seedance 2.5 vs Seedance 2.0 para saber o que muda quando você precisa de um plano único mais longo.
A estrutura aqui pode ser reutilizada para qualquer ideia de "mundo gigante, personagem em miniatura": uma ficha de personagem com a proporção declarada, um cenário construído com objetos que o espectador já reconhece, uma lista numerada de planos (cada batida encadeada na próxima), um final roteirizado com recompensa própria e uma cláusula final de consistência que repete a regra que você não pode perder. Troque a loja por uma cozinha, um jardim ou uma escrivaninha, mantenha as cinco partes intactas e execute no Seedance 2.0 na hiapi.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado