
Tutoriale
Seedance 2.0 micro parkour: prompt in cinque inquadrature per un personaggio in scala 1:15
Un'attrice stunt delle dimensioni di una mano fa parkour libero in un enorme negozio di dispositivi digitali, in cinque inquadrature meticolosamente coreografate. Questo articolo analizza battuta per battuta il prompt originale e include il modo di chiamare /v1/tasks per riprodurre l'effetto.
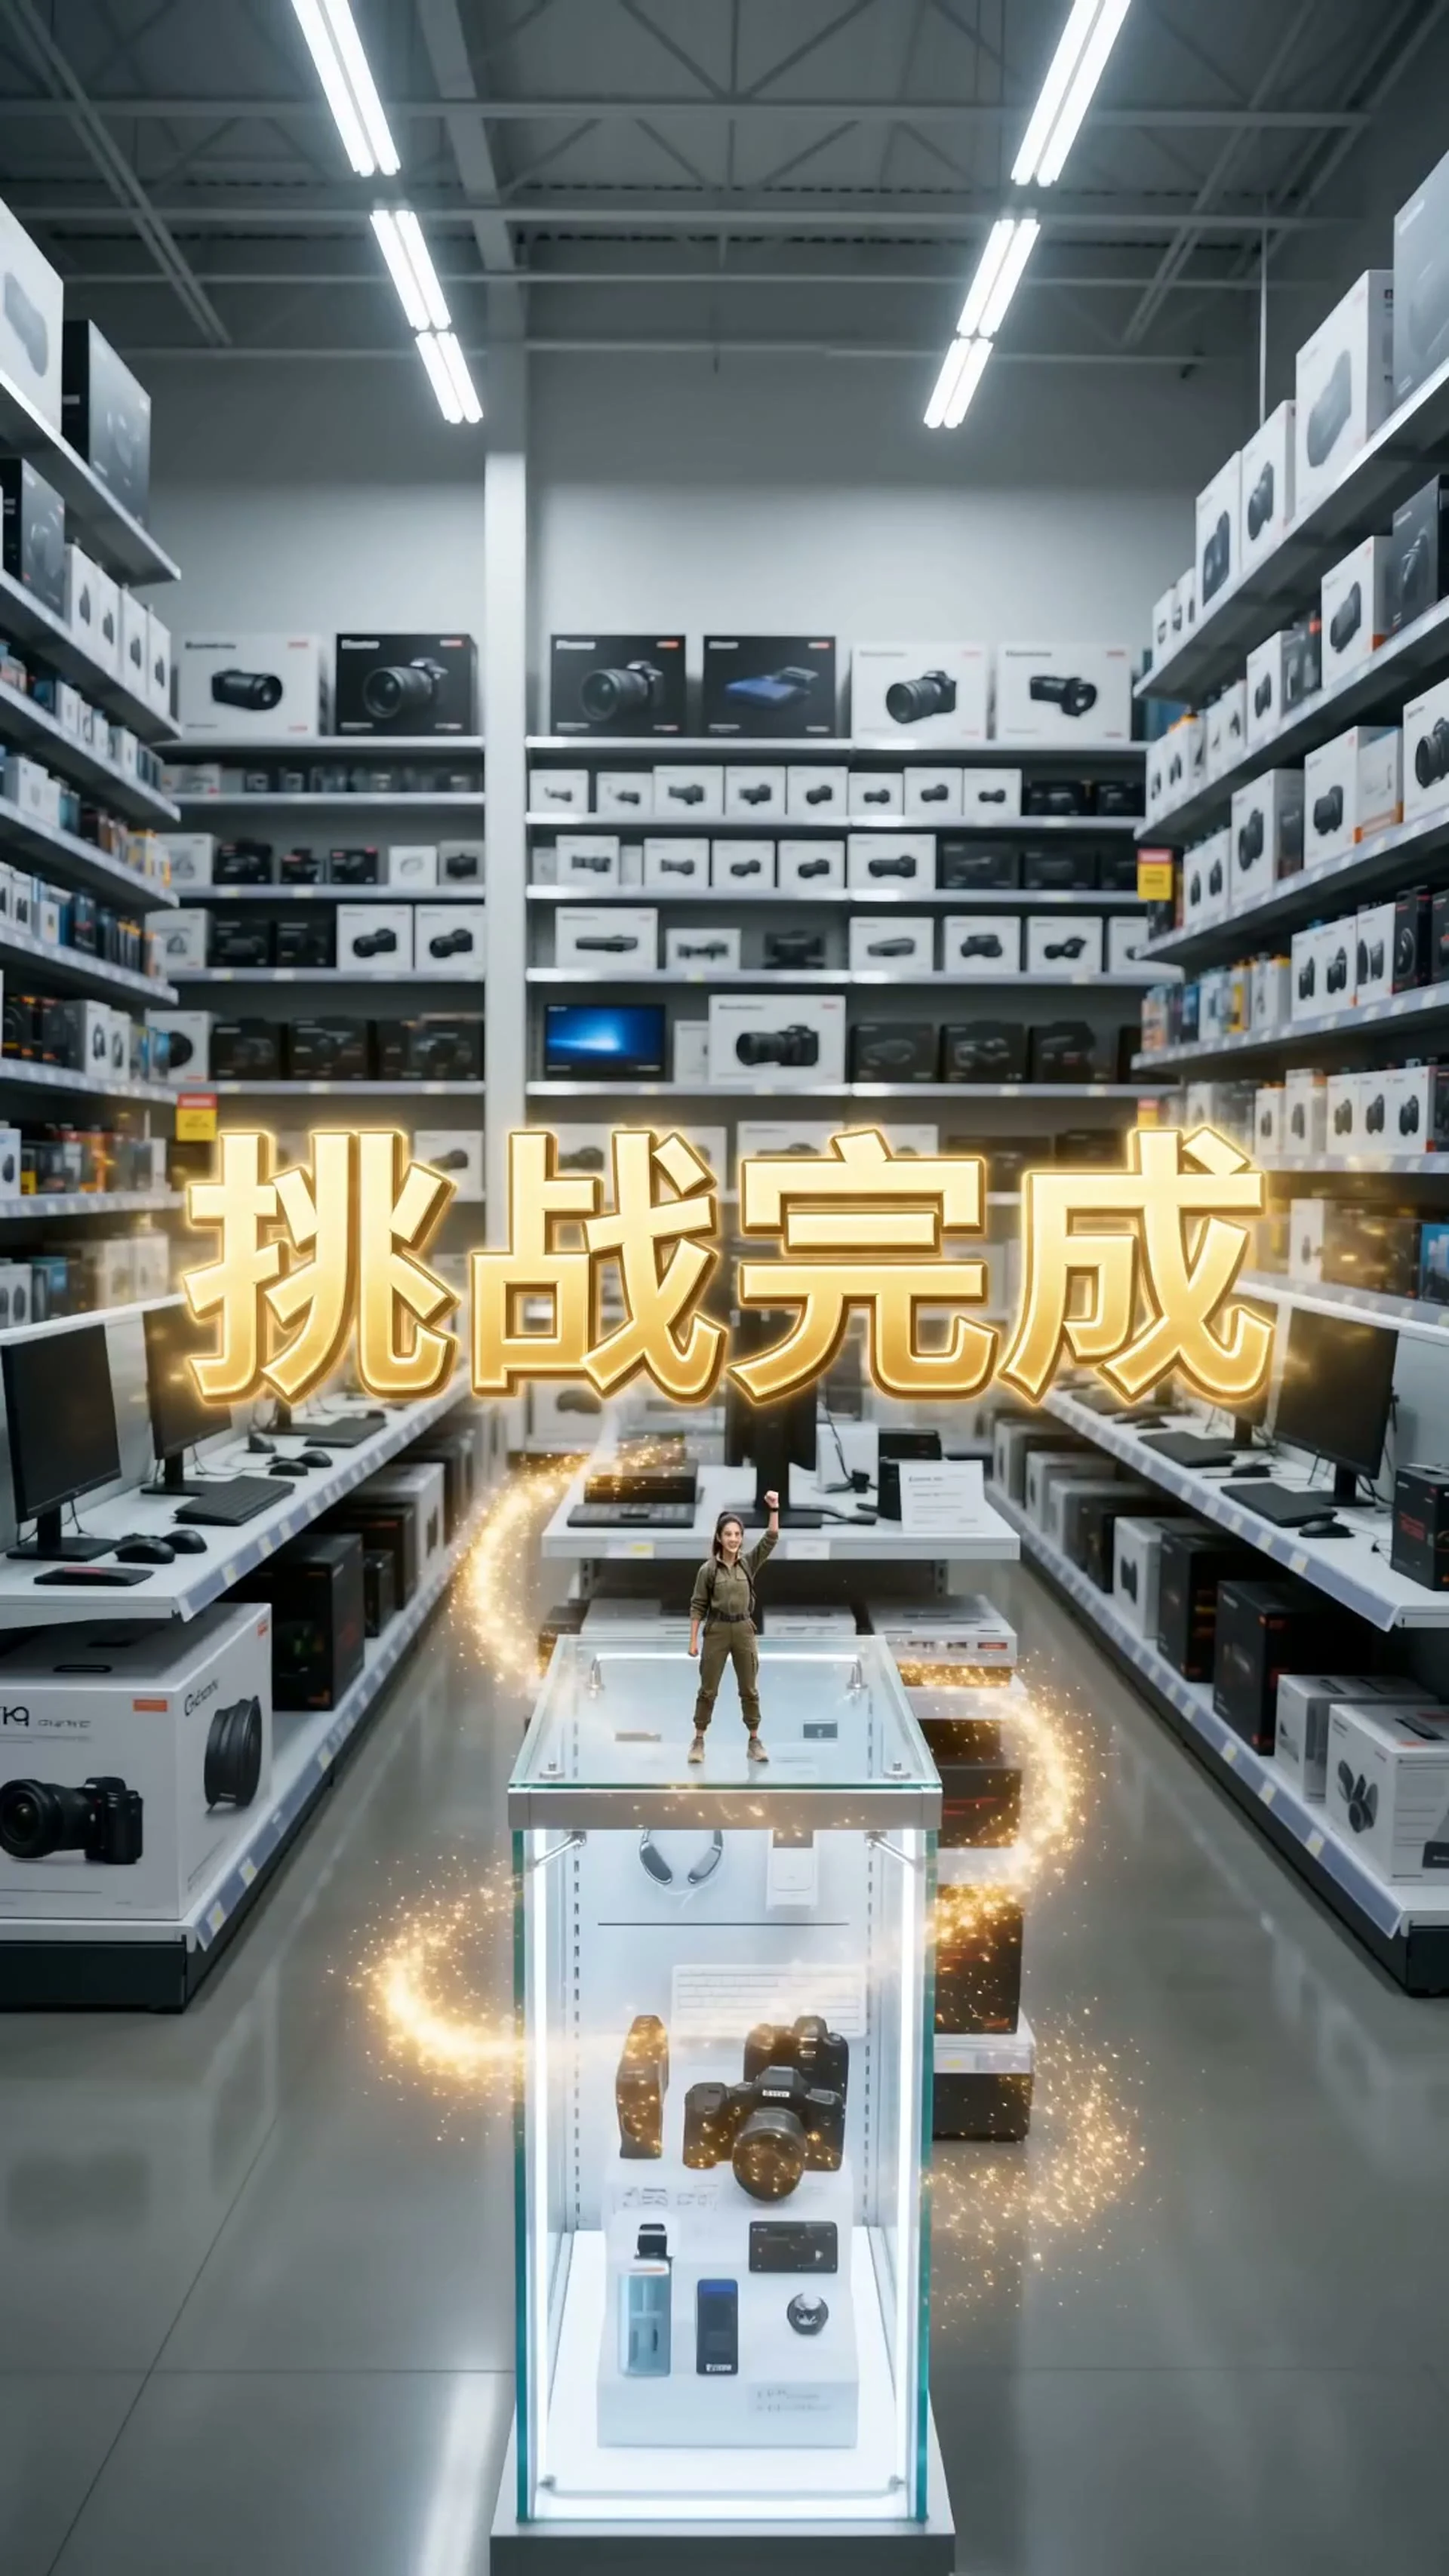
La donna in questo video è grande quanto una mano. Sta facendo parkour libero in un negozio di dispositivi digitali: salta giù da una confezione di copritasti, corre attraversando una bottiglia di detergente per schermi, scivola lungo una teleferica fatta con la maniglia di un cestino della spesa sopra le confezioni di cuffie, surfando su una bomboletta di aria compressa che rotola, e infine atterra saldamente sulla cima di una vetrina espositiva, alza il pugno e dietro di lei lampeggia in grandi caratteri dorati cinesi "sfida completata". Cinque inquadrature, una sola generazione Seedance 2.0 da 15 secondi, con lo stesso personaggio in scala 1:15 in ogni fotogramma. Questo articolo è il prompt originale che ha generato quel video, con un'analisi parte per parte di ciò che effettivamente fa.
La coerenza multi-inquadratura è il problema che la maggior parte dei prompt "personaggio minuscolo" non risolve mai. Far fare più cose a un piccolo personaggio di solito significa ottenere una faccia diversa, un abbigliamento diverso o proporzioni diverse a ogni cambio di inquadratura. Questo prompt evita il problema scrivendo tutti i 15 secondi come un'unica lista di inquadrature: una scheda del personaggio, poi cinque battute numerate, ciascuna con la propria regia di macchina e il proprio design sonoro, invece di una vaga descrizione di scena sperando che il modello mantenga la continuità da solo.
Il prompt completo
Stile: effetto persona minuscola, ripresa dal vero realistica, fotografia macro cinematografica, profondità di campo ultra ridotta, luminoso negozio moderno di dispositivi digitali, illuminazione fluorescente realistica, ultra dettagliato 8K, verticale 9:16, stile video breve virale dinamico.

Durata: 15 secondi.

Scena: un enorme negozio moderno di dispositivi digitali, pieno zeppo di scaffali altissimi con confezioni colorate di copritasti, scatole di fotocamere, scatole di obiettivi, confezioni di cuffie, tastiere, mouse, detergente per schermi, bombolette di aria compressa, schede di memoria, monitor, cestini della spesa ed etichette prezzo appese. Dal punto di vista di una donna grande quanto una mano, tutto appare gigantesco.

Personaggio: una donna minuta e atletica (scala 1:15), aspetto coerente per tutta la durata: giacca avventurosa leggera, pantaloni cargo, scarpe da ginnastica, zaino multifunzione, viso, acconciatura, proporzioni e dimensioni identici in ogni inquadratura.

00:00–00:03 — Altalena sugli scaffali digitali

Lei sta in piedi su un'enorme confezione colorata di copritasti, scatta e salta verso un'etichetta prezzo appesa, la afferra con entrambe le mani, si dondola attraverso la corsia dello scaffale e si lancia verso lo scaffale successivo. L'etichetta oscilla dietro di lei.

Inquadratura: inseguimento macro dal basso.
Audio: fruscio di plastica, passi minuscoli, sibilo del vento, suono dell'etichetta che oscilla.

00:03–00:06 — Parkour sui tappi

Atterra su un'enorme bottiglia di detergente per schermi e fa parkour sui tappi colorati. Una bottiglia ondeggia sotto di lei; ritrova l'equilibrio e fa una capriola in avanti verso lo scaffale successivo.

Inquadratura: inseguimento macro laterale rapido.
Audio: passi, scricchiolio delle bottiglie, sciabordio del liquido, atterraggio duro.

00:06–00:09 — Teleferica del cestino della spesa

Afferra una corda promozionale appesa e scivola in teleferica sopra scatole di fotocamere, confezioni di cuffie e confezioni di copritasti. Mollata la presa al momento giusto, atterra dentro un cestino della spesa in movimento, circondata da enormi confezioni di cuffie, blister di schede di memoria e kit per la pulizia degli obiettivi.

Inquadratura: transizione dall'alto verso il basso.
Audio: fischio della teleferica, vento, rotelle del cestino, impatto.

00:09–00:12 — La bomboletta di aria compressa fuori controllo

Un'enorme bomboletta metallica di aria compressa rotola dentro il cestino. Lei ci salta sopra, mantiene l'equilibrio come un surfista e la cavalca attraverso il pavimento liscio, schivando per un soffio le scarpe dei clienti, i cestini e le confezioni sparse di accessori digitali.

Inquadratura: inseguimento macro radente al pavimento.
Audio: rotolamento metallico, vento, suoni ambientali del negozio.

00:12–00:15 — Finale di vittoria

Usando la bomboletta rotolante come rampa di lancio, salta verso la maniglia della vetrina, si arrampica e si erge trionfante in cima alla vetrina. L'enorme negozio di dispositivi digitali si estende dietro di lei, mentre appaiono particelle scintillanti e grandi caratteri dorati cinesi mostrano:

"Sfida completata"

Lei alza un pugno, mentre la macchina da presa si allontana lentamente, sottolineando le sue minuscole proporzioni.

Inquadratura: allontanamento cinematografico.
Audio: sibilo del salto, presa metallica, campane di vittoria, scintillio, suoni ambientali del negozio.

Requisiti visivi: mantenere la coerente scala miniaturizzata 1:15, fisica realistica, movimento fluido e continuo, packaging realistico, riflessi reali, profondità di campo macro cinematografica e identità del personaggio coerente. Nessuna animazione, cartone animato, voce fuori campo, sottotitoli, cambi d'abbigliamento o incoerenza di proporzioni.
Il prompt è scritto in cinese e Seedance 2.0 lo renderizza senza alcun passaggio di traduzione: al modello non importa in che lingua sia il prompt. Ecco, in ordine, cosa fa ciascun blocco.
1. Bloccare il personaggio prima della prima inquadratura
Personaggio: una donna minuta e atletica (scala 1:15), aspetto coerente per tutta la durata: giacca avventurosa leggera, pantaloni cargo, scarpe da ginnastica, zaino multifunzione, viso, acconciatura, proporzioni e dimensioni identici in ogni inquadratura.
("Personaggio: una donna minuta e atletica, scala 1:15, aspetto coerente in tutto il filmato: giacca avventurosa leggera, pantaloni cargo, scarpe da ginnastica, zaino multifunzione, stessa faccia, acconciatura, proporzioni e dimensioni in ogni inquadratura.")
Questo paragrafo compare prima di qualsiasi descrizione di scena e fa una sola cosa: dà al modello un'unica scheda del personaggio da riutilizzare per tutti i quindici secondi successivi, invece di reimmaginarla per ogni battuta. La scala è scritta esplicitamente come numero ("1:15"), non con un vago "tiny" o "miniature", e l'abbigliamento è abbastanza specifico da non lasciare al modello spazio di improvvisazione tra un'inquadratura e l'altra. La frase dei requisiti visivi in chiusura ripete lo stesso vincolo da un'altra direzione: "identità del personaggio coerente... nessun cambio d'abbigliamento o incoerenza di proporzioni"; così la regola è dichiarata sia all'inizio sia alla fine del prompt.
2. Costruire il mondo con oggetti quotidiani ingranditi
Scena: un enorme negozio moderno di dispositivi digitali, pieno zeppo di scaffali altissimi con confezioni colorate di copritasti, scatole di fotocamere, scatole di obiettivi, confezioni di cuffie, tastiere, mouse, detergente per schermi, bombolette di aria compressa, schede di memoria, monitor, cestini della spesa ed etichette prezzo appese.
Il negozio di dispositivi digitali è una scena perfetta proprio perché non contiene nulla di esotico: sacchetti di copritasti, bottiglie di detergente per schermi, bombolette di aria compressa, cestini della spesa. Alla scala 1:15, la normale cianfrusaglia da vendita al dettaglio diventa una palestra di parkour: le etichette prezzo diventano altalene di corda, i tappi diventano travi di equilibrio, le bombolette che rotolano diventano tavole da surf. Il trucco degli "oggetti quotidiani giganti" fa il lavoro visivo che una scena più strana non riuscirebbe a fare: l'umorismo e il senso della scala nascono dal fatto che lo spettatore riconosce cosa sia davvero quell'oggetto.
3. Scrivere le cinque inquadrature come una lista di riprese stunt
Invece di un'unica indicazione di regia continua, il prompt suddivide i 15 secondi in cinque battute etichettate, ciascuna con il proprio timestamp, la propria regia di macchina e il proprio design sonoro:
| Battuta | Azione | Inquadratura | Audio |
|---|---|---|---|
| 00:00–00:03 | Oscillazione sulle etichette prezzo appese tra gli scaffali | Inseguimento macro dal basso | Fruscio di plastica, passi minuscoli, sibilo del vento, suono dell'etichetta che oscilla |
| 00:03–00:06 | Parkour su tappi ondeggianti | Inseguimento macro laterale rapido | Passi, scricchiolio delle bottiglie, sciabordio del liquido, atterraggio duro |
| 00:06–00:09 | Teleferica sopra le scatole e caduta nel cestino in movimento | Transizione dall'alto verso il basso | Fischio della teleferica, vento, rotelle del cestino, impatto |
| 00:09–00:12 | Surf sul pavimento su una bomboletta di aria compressa che rotola | Inseguimento macro radente al pavimento | Rotolamento metallico, vento, suoni ambientali del negozio |
| 00:12–00:15 | Lancio dalla bomboletta verso la vetrina per il finale | Allontanamento cinematografico | Sibilo del salto, presa metallica, campane di vittoria, scintillio, suoni ambientali del negozio |
Ogni battuta si collega fisicamente alla successiva: atterra dall'altalena ed entra nel parkour sui tappi, fa una capriola dal parkour sui tappi ed entra nella teleferica, cade dalla teleferica sulla bomboletta che rotola, e dalla bomboletta si lancia nel finale. È proprio questa concatenazione che fa leggere cinque inquadrature separate come un unico inseguimento continuo, invece di cinque frammenti scollegati montati insieme.
4. Scrivere il finale come ricompensa, non solo come un'altra battuta
Usando la bomboletta rotolante come rampa di lancio, salta verso la maniglia della vetrina, si arrampica e si erge trionfante in cima alla vetrina... mentre appaiono particelle scintillanti e grandi caratteri dorati cinesi mostrano: "Sfida completata"
Le prime quattro battute sono slancio e pericolo; solo la quinta chiude tutto. Dare al finale una ricompensa propria — atterraggio saldo, macchina che si allontana, particelle scintillanti, premio testuale sullo schermo — è la chiave che trasforma un parkour in una storia completa, invece che in un loop che si può interrompere a qualsiasi battuta. È lo stesso principio dello scrivere esplicitamente una destinazione in un volo in soggettiva in un'unica inquadratura (si veda la nostra analisi del volo in prima persona in un'unica inquadratura con Seedance 2.0): una sequenza a più battute ha bisogno di una fine scritta nel prompt, altrimenti semplicemente si ferma.
5. Chiudere con una clausola ferrea di coerenza
Requisiti visivi: mantenere la coerente scala miniaturizzata 1:15, fisica realistica, movimento fluido e continuo, packaging realistico, riflessi reali, profondità di campo macro cinematografica e identità del personaggio coerente. Nessuna animazione, cartone animato, voce fuori campo, sottotitoli, cambi d'abbigliamento o incoerenza di proporzioni.
L'ultima riga è una checklist, non testo decorativo: scala 1:15 coerente, fisica realistica, movimento fluido e continuo, packaging realistico, riflessi reali, profondità di campo macro cinematografica, identità coerente, e poi una breve blacklist delle modalità di fallimento che effettivamente compaiono nei prompt con personaggi minuscoli (rendering animato/cartonesco, voce fuori campo, sottotitoli impressi, deriva dell'abbigliamento, deriva delle proporzioni). Ogni voce della lista corrisponde a qualcosa già dichiarato prima nel prompt; questa sezione serve solo a renderla non negoziabile.
Eseguirlo su hiapi
Una chiamata asincrona al task, poi polling per il risultato:
# 1. Create the task
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0",
    "input": {
      "prompt": "风格:微型小人特效,逼真的实景拍摄... (the full prompt above)",
      "aspect_ratio": "9:16",
      "duration": 15,
      "resolution": "1080p",
      "generate_audio": true
    }
  }'

# 2. Poll until status = success, then download output[0].url
curl https://api.hiapi.ai/v1/tasks/$TASK_ID \
  -H "Authorization: Bearer $HIAPI_TOKEN"
Due consigli pratici:
- Il costo è al secondo, per fascia di risoluzione. Ad ottobre 2026: 480p a $0,136/secondo, 720p a $0,293/secondo, 1080p a $0,729/secondo, 4k a $1,486/secondo. Una clip di 15 secondi come questa costa circa $2,04 a 480p, circa $4,40 a 720p, circa $10,94 a 1080p e circa $22,29 a 4k con lo stesso prompt: scegli la fascia adatta all'uso della ripresa. I prezzi attuali sono nella pagina dei prezzi e nella pagina del modello Seedance 2.0.
- Verticale e orizzontale funzionano allo stesso modo. Questa clip viene renderizzata con
aspect_ratio: "9:16"invece del solito16:9: il prezzo al secondo e i limiti di durata non cambiano con l'orientamento, cambia solo la forma del fotogramma. Per la tabella completa dei parametri (primo/ultimo fotogramma, immagini di riferimento, altri rapporti d'aspetto) si veda la guida API di Seedance 2.0.
Domande frequenti
Seedance 2.0 riesce davvero a mantenere lo stesso personaggio coerente attraverso cinque acrobazie diverse in un'unica generazione?
Sì, in un'unica generazione: è proprio questo su cui si basa il prompt. La scheda del personaggio ("scala 1:15, stessa faccia, acconciatura, proporzioni e dimensioni in ogni inquadratura") compare prima di ciascuna delle cinque battute, e la frase dei requisiti visivi ripete lo stesso vincolo alla fine. Togli una delle due e la deriva di proporzioni/identità tra un'inquadratura e l'altra è il fallimento più comune.
La sovrapposizione testuale "sfida completata" viene dalla stessa generazione?
Sì: è scritta come elemento di scena nella battuta finale ("grandi caratteri dorati cinesi mostrano: 'sfida completata'"), allo stesso modo delle particelle scintillanti e delle campane di vittoria. Nulla in questa clip è stato composto in post-produzione.
Il verticale 9:16 è disponibile in ogni fascia di risoluzione?
Seedance 2.0 supporta rapporti d'aspetto verticali e orizzontali nelle stesse fasce di risoluzione; il prezzo è al secondo per risoluzione, non per orientamento. Prima di bloccare la ripresa su una forma del fotogramma specifica, controlla la pagina del modello per l'elenco attuale dei rapporti d'aspetto.
E se volessi più di cinque battute, o più di 15 secondi?
15 secondi è la durata massima di una singola generazione per questo modello. Per sequenze più lunghe, pianificale come più generazioni da 15 secondi, inserendo in ogni prompt il testo della scheda del personaggio corrispondente, oppure consulta il confronto tra Seedance 2.5 e Seedance 2.0 per capire cosa cambia quando serve un'unica inquadratura più lunga.
La struttura qui descritta è riutilizzabile per qualsiasi idea di "mondo gigante, personaggio minuscolo": una scheda del personaggio che ne indica la scala, una scena costruita con oggetti che lo spettatore riconosce, una lista numerata di inquadrature (ogni battuta collegata alla successiva), un finale sceneggiato con una ricompensa propria, e una clausola finale di coerenza che ripete le regole a cui non puoi rinunciare. Sostituisci il negozio con una cucina, un giardino o una scrivania, mantieni intatte le cinque parti, poi eseguilo su Seedance 2.0 su hiapi.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato