使用ガイド
gemini-4-hydrogen 入門ガイド:能力の境界、パラメータの要点、導入実践
エンジニアリングチーム向けのテキストモデル導入と選定の参考
このページの内容
gemini-4-hydrogen の位置づけと能力の境界
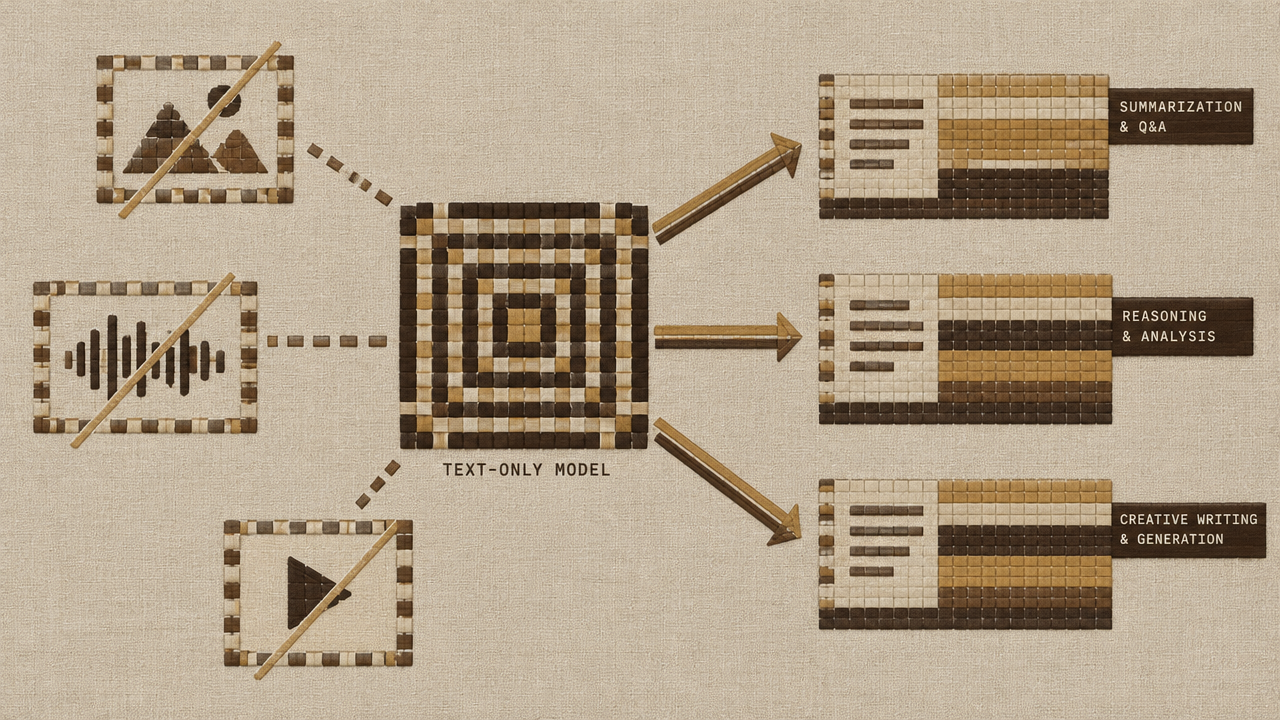
gemini-4-hydrogen は Google が提供するテキストモデルです。出力タイプはプレーンテキストであり、この点がアーキテクチャ上どこに配置すべきかを決めます。テキスト入力・テキスト出力の工程に置くべきであり、マルチモーダルパイプラインの一部ではありません。
得意なこと
エンジニアリングの観点では、プレーンテキスト出力モデルの最も典型的な用途は「中間生成物がテキストである」タスクです。
- 構造化抽出と変換:非構造化テキストを JSON、表の行、フィールド一覧などの取り決めた形式に変換する。
- 要約と書き換え:長文ドキュメントの圧縮、トーンの調整、多言語表現の統一。
- 分類と判定:意図認識、コンテンツ分類、チケットルーティングなど、短い出力で低遅延を実現する。
- 生成系の補助:下書き作成、コードコメントの補完、プロンプトの拡張など、人によるレビューの前段階。
- 対話と質疑応答:検索コンテキストがある前提で回答を組み立てる。
これらのタスクに共通する特徴は、入力がテキストにシリアライズでき、出力が下流のプログラムでパースでき、結果をサンプリングしてレビューできることです。
向かないこと
同じくエンジニアリングの判断として、境界をあらかじめ明確にしておく必要があります。
- 画像、音声、動画を直接生成することを期待しない。出力形態はテキストであり、マルチモーダル生成を含む経路は別の場所で組み合わせる必要があります。
- 強い決定性を持つ計算機として扱わない。正確な算術や厳密なルール検証といったロジックは、モデルではなくコードに任せます。
- コンテキストなしで事実に関する断定をさせない。外部知識が必要な場面では、まず検索で資料を入力に含めてから回答を組み立てさせます。
- リアルタイム事象の唯一の情報源にしない。モデルの内部知識にはカットオフがあり、鮮度が求められる内容はあなたのシステムから注入する必要があります。
これらをチームの設計ドキュメントに書き込んでおく方が、後から下流にパッチを当てるよりはるかに安上がりです。
導入前に確認すべきいくつかのこと
最初の呼び出しコードを書く前に、いくつかの点を明確に確認しておく価値があります。そうしないと、デバッグ段階で無駄な調査が多く発生します。
タスク形態と出力契約を明確にする
まず三つの問いに答えます。入力は単一ターンか複数ターンか。出力は自由テキストか、それとも何らかの構造に従う必要があるか。失敗時に下流はリトライを許容できるか。この三つの答えが、その後のプロンプトの書き方、出力長の上限設定、検証方法を直接決めます。
認証情報と呼び出しエントリポイント
最終的にどの導入方式を採るにせよ、管理可能でローテーション可能な API 認証情報が必要であり、認証情報をフロントエンドコードに書いたりリポジトリにコミットしたりしないでください。推奨される方法は、認証情報をサーバー側の環境変数やシークレット管理サービスに置き、バックエンドが一元してモデルを呼び出し、フロントエンドはあなたのバックエンドとのみ通信する構成です。これにより漏洩を避けつつ、後から業務単位でクォータや監査を行うのも容易になります。
ネットワークとタイムアウトの予算
テキストモデルの1リクエストの所要時間は、入力長と出力長によって変化します。リリース前に、あなたの業務が許容できる最大応答時間を決めます。そこから逆算してリクエストのタイムアウト、リトライ回数、フォールバック戦略を決めます。「モデルが不安定」というフィードバックの多くは、実際にはタイムアウト設定と業務の期待が噛み合っていないことが原因です。
可観測性を機能より先に
業務ロジックを書く前に、ログのフィールドを決めておきます。リクエスト ID、入力 token 数、出力 token 数、所要時間、エラーコード。これらは後段のコスト計算や問題特定でほぼ必須であり、後から追加しようとするとコードを一通り修正することになります。
コンプライアンスとデータ境界
送信する内容にユーザープライバシー、認証情報、社内ドキュメントなどの機密情報が含まれるかどうかを確認し、どのフィールドをモデルへ送る前にマスキングすべきかを明確にします。
呼び出しパラメータとリクエスト構成の要点
典型的な呼び出しは三つの部分からなります。入力内容、制御パラメータ、返却結果です。結果の品質とコストに実際に影響するのは、通常ごく少数のパラメータだけです。
入力内容の組み立て方
入力を「指示 + コンテキスト + 処理対象データ」の三層として捉えます。
- 指示を先頭に置き、役割とタスクの目標を示す。
- コンテキスト(検索された資料、過去の対話)を中間に置き、明確に区切る。
- 処理対象データを最後に置き、指示が要求する作用対象に隣接させる。
複数ターンの対話では、履歴を無限に積み上げるのではなく直近の数ターンを保持します。履歴が長いほど入力側の消費が増え、またノイズが重要情報を薄めます。長期記憶が必要な内容は、原文を丸ごと持ち回すのではなく要約して注入することを推奨します。
重要なパラメータ
- 出力長の上限:最も見落とされやすく、しかもコストと体験の両方に影響するパラメータです。小さすぎると回答が途中で切れ、大きすぎるとモデルに「おしゃべり」の余地を与えます。タスク種別ごとに段階を分けることを推奨します。分類タスクには非常に小さな上限を与え、長文生成のときだけ開放します。
- temperature / top-p などのサンプリングパラメータ:抽出、分類、形式変換など安定した出力が必要なタスクではランダム性を低くします。コピー生成系は適度に開放してよいでしょう。同一業務内では一貫させ、回帰比較をしやすくします。
- 停止条件:下流が出力をある地点で終わらせる必要がある場合(たとえば最初の JSON だけを取るなど)、停止シーケンスで制約する方が事後の正規表現トリミングより信頼できます。
- 構造化出力の制約:プログラムでパースする必要がある場合、指示にフィールド名、型、例を示し、「JSON のみを出力し、説明を付けない」ことを明確にします。
リクエスト構成に関するいくつかの経験
- プロンプトと業務コードを分離し、バージョン管理可能なテンプレートにして A/B 比較を容易にする。
- 出力のパースにフォールバックを用意する。パース失敗時は生の返却を記録し、ユーザーへ直接エラーを投げない。
- 同一リクエストに冪等キーを設定し、リトライによる重複課金や重複副作用を避ける。
- 長い入力の場面ではまず分割と絞り込みを行い、無関係な段落をモデルの外に排除する。これが最も直接的なコスト削減手段です。
token 課金でのコスト見積もりと制御
gemini-4-hydrogen は token 単位で課金されます。つまりコストはほぼ二つのことだけで決まります。1リクエストあたりどれだけの token を送り込むか、そしてモデルがどれだけの token を吐き出すか。価格の数値はサイトの価格パネルを参照してください。ここでは方法だけを扱います。
見積もりの習慣をつける
感覚で見積もってはいけません。やり方は、まず実際のサンプルを一通り実行し、各リクエストの入力 token と出力 token の数を記録し、業務シーンごとにグループ化して平均値と分位点を集計します。「平均 token 数 × 日次平均呼び出し量」で桁感の見積もりを得て、さらに P95 で最悪ケースを見ます。シーンによって分布の差が非常に大きく、一律の平均値で見積もると大きくずれることがわかります。
コスト制御の具体的なポイント
- 入力の圧縮:重複するシステムプロンプトを削除し、無関係なコンテキストを削り、長文ドキュメントはまず要約してから送る。入力側は通常コストの大半を占め、効果も最も直接的です。
- 出力の制限:出力長の上限と「簡潔に回答してください」といった指示により、冗長な出力を直接抑えます。
- 段階的な呼び出し:単純な分類や形式検証は小さなリクエストで済ませ、本当に生成能力が必要なときだけ完全な呼び出しを行います。
- キャッシュと重複排除:同一または高度に類似したリクエストの結果をキャッシュします。特にバッチのオフラインタスクで有効です。
- バッチと非同期:リアルタイムでないタスクはまとめて処理し、重複する固定オーバーヘッド部分を減らします。
コストを可観測な指標にする
ログに業務ライン単位で token 消費を記録し、日次・週次のトレンドダッシュボードにします。ある日消費が異常に増えた場合、通常は三つの原因に対応します。呼び出し量の増加、入力の長文化(たとえばコンテキスト結合ロジックの変更)、出力の長文化(たとえばプロンプトの変更)。この三点を監視項目にしておくと、事後の追跡を大幅に省けます。
最後に一言:コスト最適化を出力品質の犠牲の上に行ってはいけません。まず評価セットを構築してから、圧縮の話をしましょう。
集約 API プラットフォームでの導入とマルチモデル比較
多くのチームにとって、選定段階で最大のコストはコードを書くことではなく、「モデルを変えるたびに導入層を書き直す」ことです。統一エントリポイントで導入すれば、このコストを最小限に抑えられます。
統一インターフェースの利点
集約 API プラットフォームでは、モデルの呼び出し方が同一のリクエスト構造に統一されます。同じ認証方式、同じメッセージ形式、同じ返却パースロジックです。モデルを変えるときは通常モデル識別子を変えるだけで、業務コードはほぼそのままです。これにより得られる直接のメリットは次のとおりです。
- 導入層は一度書くだけで、複数モデルで共用できる。
- 評価段階で低コストに横並び比較ができる。
- 本番環境でカナリアリリースと素早いロールバックができる。あるモデルで問題が起きたとき、代替への切り替えは設定変更だけで済む。
このモデルの導入情報と可用性はモデルページから取得できます:/models/gemini-4-hydrogen。
同じ課題での比較を行う
ランキングだけを見てはいけません。やり方は、自社の評価セットを用意し、業務の実際の分布をカバーする 20 から 50 件のサンプルを含め、単純なケース、境界ケース、長入力ケースを網羅したうえで、次のように行います。
- 同一のプロンプトテンプレートで複数の候補モデルを実行する。
- 出力品質(人手またはルールによる採点)、所要時間、token 消費を記録する。
- 平均点ではなく通過率と失敗パターンに注目する。
- 差が顕著なサンプルについて原因を分析する。指示追従の問題か、形式の問題か、それとも長いコンテキストの切断か。
切り替えと共存の戦略
評価の結論は「一つのモデルだけを使う」ではなく、「シーンごとに役割分担する」ことが多いです。たとえば、分類と抽出には低遅延モデル、長文生成には出力品質のより良いモデルを使います。統一エントリポイントにより、この役割分担を設定層で表現でき、複数 SDK を維持する必要がありません。同時に、導入層にモデル識別子の設定スイッチを残し、カナリアリリースと組み合わせて段階的に流量を増やすことを推奨します。
リリース前の検証チェックリストとよくある問題の調査
リリース前の検証チェックリスト
次の手順を順番に完了してから、流量の拡大を検討します。
- スモークテスト:最短のリクエストが正常に返るか、認証とネットワークは通っているか。
- 形式検証:構造化出力の場面で、バッチサンプルのパース成功率はどれくらいか、パース失敗時の返却はどのようなものか。
- 境界入力:超長入力、空入力、特殊文字や多言語を含む入力で、それぞれどう振る舞うか。
- 出力長:最悪ケースで出力が切断されないか、切断時に下流が識別できるか。
- 並行性とタイムアウト:想定ピーク並行性の下で、タイムアウト率とエラー率は許容できるか。
- フォールバック経路:主モデルが使えないとき、代替への切り替えやフォールバック結果の返却経路が実際に通るか。
- コストのベースライン:典型的な流量1回分の token 消費を記録し、以降の監視の基準とする。
よくある問題と調査順序
リクエストタイムアウト:まず入力が長すぎないか(特にドキュメント全体を突っ込んでいないか)を見て、次に出力上限が大きすぎないかを確認し、最後にクライアントのタイムアウトとリトライ戦略が妥当かを確認します。リトライにはバックオフを付け、雪崩を避けます。
出力の切断:出力長の上限を確認し、プロンプトで長すぎる内容を要求していないかも確認します。停止シーケンスの設定が不適切で早期終了している場合もあります。
出力が不安定で形式が良くなったり悪くなったりする:まずサンプリングのランダム性を下げます。次に指示が明確か(フィールド名、型、例がそろっているか)を確認します。さらに、入力に矛盾する例が混入していないか確認します。
内容が指示から逸脱する:よくある原因は、コンテキストが長すぎて重要な指示が薄まることです。指示を入力の末尾に移して一度繰り返すか、コンテキストを圧縮すると通常改善します。
コストの異常な増加:先に挙げた三つの原因(呼び出し量、入力長、出力長)に沿って、ログのトレンドと一つずつ突き合わせます。
結果が再現できない:リクエストパラメータとテンプレートのバージョンを記録します。モデルの出力自体にランダム性があるため、逐語的な再現を期待せず、検証はルールまたは人手の採点に基づいて行います。
このチェックリストをリリースフローに組み込む方が、毎回リリース時にその場で対応するよりはるかに安定します。選定と導入の具体的な詳細は、まずモデルページ /models/gemini-4-hydrogen から確認を始めてください。