
Guida all'uso
Video Seedance 2.0 in un unico piano sequenza: analisi del prompt per una traversata in prima persona in 4K
Un solo prompt, nessun montaggio, audio nativo. Questo è il nostro video reale di 15 secondi in 4K di una traversata subacquea, con un'analisi sezione per sezione che spiega perché il prompt funziona e la chiamata /v1/tasks necessaria per eseguirlo.
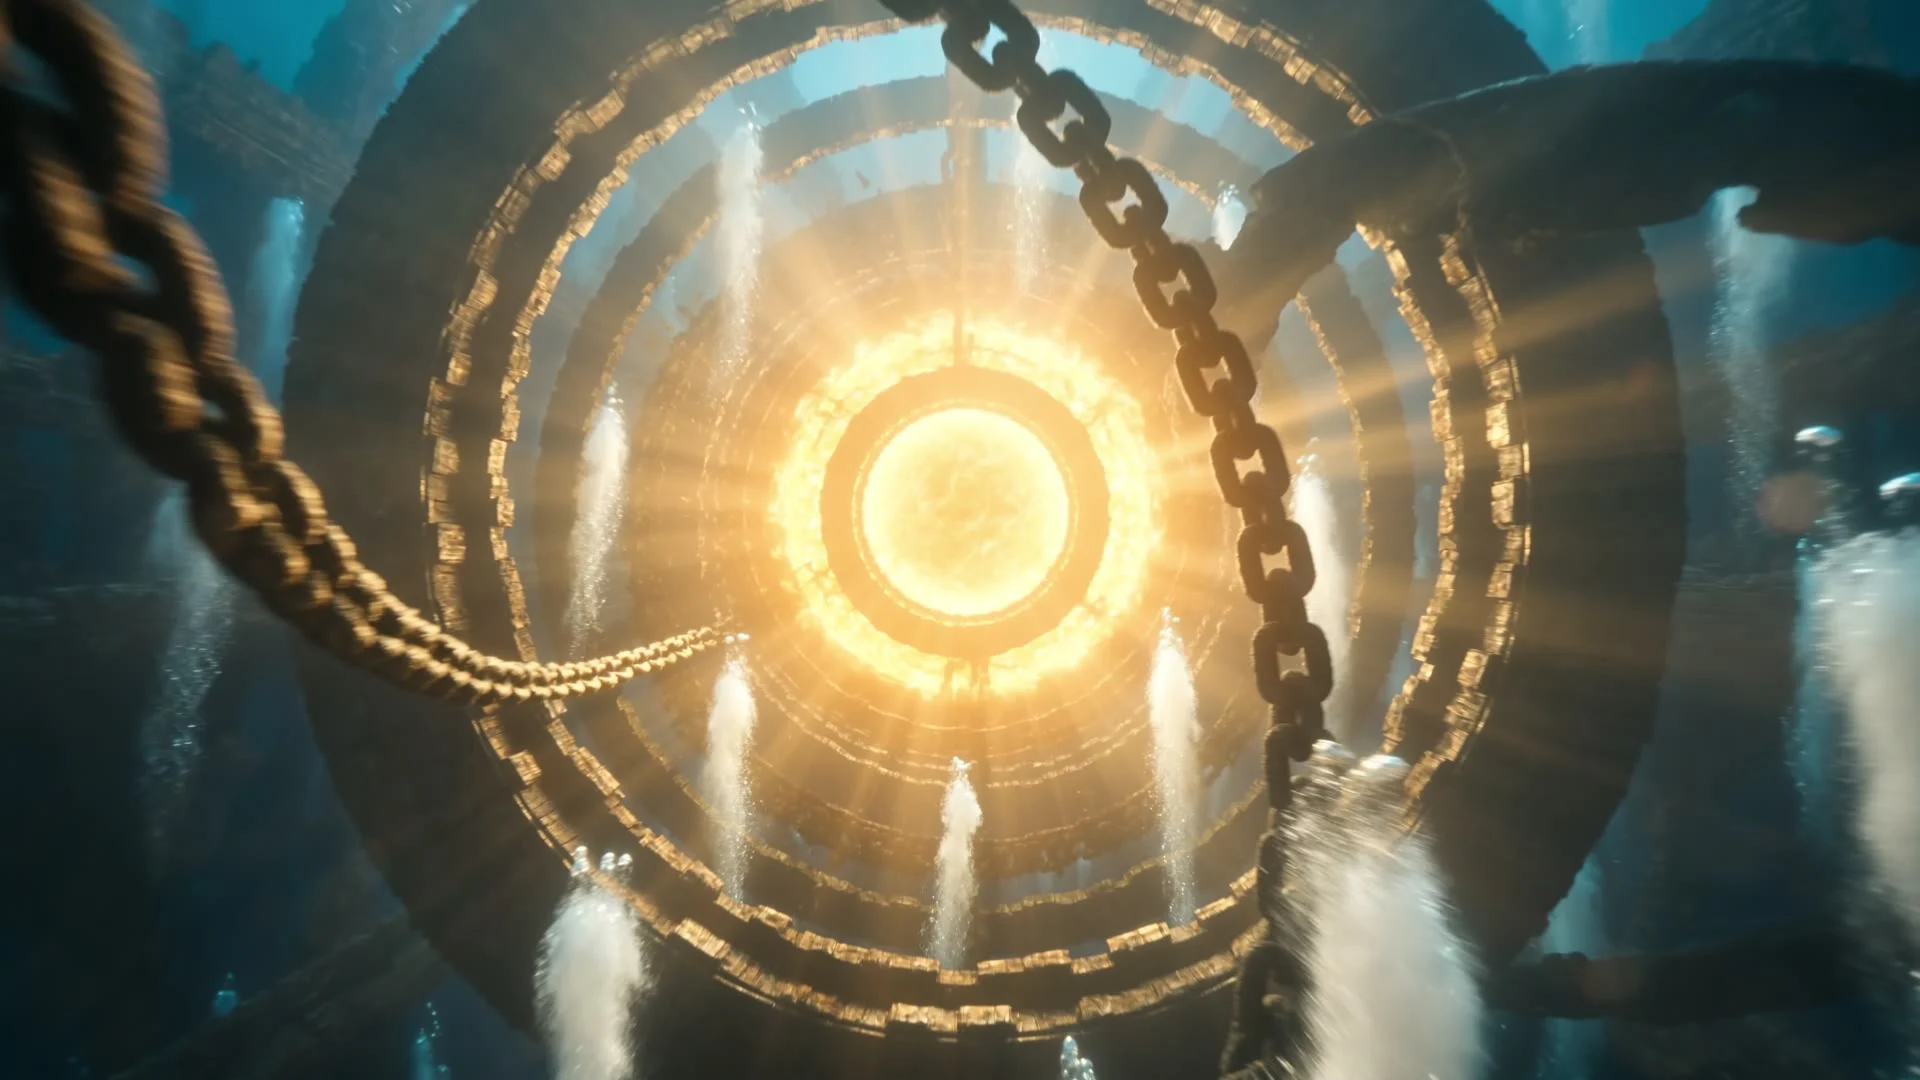
Il video qui sotto è un unico piano continuo: una discesa in prima persona in un tempio sommerso, che sfreccia di lato attraverso archi, statue e catene alla deriva, per fermarsi infine su un enorme "sole artificiale" che si risveglia dentro un anello di pietra. È generato da Seedance 2.0 con un'unica generazione da testo a video — nessun montaggio, nessun keyframe, nessuna post-produzione — e anche il rombo che sentite è prodotto nella stessa generazione, dallo stesso prompt. Lo abbiamo pubblicato come showcase sul nostro account X; questo articolo presenta il prompt completo che ne sta alla base e spiega perché ogni sua parte esiste.
Il piano sequenza in soggettiva è esattamente il punto in cui i modelli text-to-video di solito falliscono. Se vi limitate a dire "una telecamera vola sopra delle rovine sommerse", ottenete uno di tre esiti negativi: il modello passa a metà a una nuova angolazione; mostra l'oggetto che trasporta la telecamera; oppure la traiettoria di volo è senza meta, perché non ha una destinazione. Questo prompt è costruito per bloccare tutti e tre gli esiti contemporaneamente.
Il prompt completo
Prospettiva di telecamera in planata immersiva in prima persona, nessun drone, subacqueo, sottomarino o qualsiasi dispositivo di volo visibile nell'inquadratura. La telecamera si tuffa attraverso un enorme tempio subacqueo perduto, sepolto nell'abisso, sfrecciando tra archi di ossidiana infranti, coralli bioluminescenti, antiche statue sottomarine, catene alla deriva, colonne di ossa di balena, rune blu luminescenti incise su pareti di pietra sommerse, banchi di pesci argentati che si disperdono, bolle, granelli di sabbia e un'enorme ombra in movimento dietro le rovine. Infine, il corridoio del tempio conduce a un enorme nucleo celeste subacqueo, come un sole marino artificiale intrappolato in un meccanismo circolare di pietra, che emana onde di luce dorata, bolle in risalita, anelli di pietra fluttuanti e onde d'urto che ondeggiano nel corpo idrico. Inquadratura POV continua, senza tagli, forte inclinazione laterale, oggetti in primo piano che sfiorano da vicino, slancio rapido in avanti, motion blur cinematografico, nebbia subacquea volumetrica, fasci di luce caustica, contrasto blu profondo e oro, VFX fantasy di alto livello, atmosfera epica e misteriosa, massima qualità cinematografica, qualità da showcase video AI di livello superiore, 4K HD. Audio: rombo subacqueo profondo, suono turbolento della pressione dell'acqua, bolle che sfrecciano accanto, risonanze lontane simili a quelle delle balene, il meccanismo di pietra che si risveglia, impatti cinematografici bassi e profondi, impulso di energia dorata alla rivelazione finale. Nessun testo leggibile, nessun essere umano, nessun logo, nessuno stile cartoon, nessuna telecamera tremolante di bassa qualità.
Si legge lungo, ma ogni proposizione fa il suo lavoro — Seedance 2.0 accetta prompt fino a 20.000 caratteri, quindi la lunghezza non è il limite: lo è la struttura. Di seguito scomponiamo lo stesso prompt nei sei compiti che assolve.
1. Bloccare la telecamera, vietare i supporti
Prospettiva di telecamera in planata immersiva in prima persona, nessun drone, subacqueo, sottomarino o qualsiasi dispositivo di volo visibile nell'inquadratura.
La prima frase parla esclusivamente della telecamera, senza ancora alcun elemento di scena. I modelli addestrati su riprese reali associano una telecamera subacquea in movimento all'oggetto che la trasporta, quindi, senza vincoli, tendono spesso a renderizzare droni, mani di subacquei o oblò di sottomarini nell'inquadratura. Dire solo "prima persona" non basta — bisogna vietare per nome ogni possibile supporto. L'ultima riga del prompt fa lo stesso lavoro per la qualità della telecamera ("nessuna telecamera tremolante di bassa qualità").
2. Costruire un corridoio di oggetti che sfiorano
...sfrecciando tra archi di ossidiana infranti, coralli bioluminescenti, antiche statue sottomarine, catene alla deriva, colonne di ossa di balena, rune blu luminescenti incise su pareti di pietra sommerse, banchi di pesci argentati che si disperdono, bolle, granelli di sabbia e un'enorme ombra in movimento dietro le rovine.
Un piano sequenza ha bisogno di qualcosa che sfrecci accanto. Una scena vaga ("belle rovine antiche") lascia la telecamera priva di riferimenti per il movimento relativo, e il risultato, anche se veloce, sembra una lenta deriva. Questa lista è volutamente densa — nove categorie di oggetti su scale diverse, dai granelli di sabbia alle colonne di ossa di balena — e la frase "oggetti in primo piano che sfiorano da vicino, slancio rapido in avanti, forte inclinazione laterale" converte questa densità in parallasse. È proprio il passaggio ravvicinato degli oggetti in primo piano a rendere credibile la sensazione di velocità.
3. Scrivere il finale
Infine, il corridoio del tempio conduce a un enorme nucleo celeste subacqueo, come un sole marino artificiale intrappolato in un meccanismo circolare di pietra, che emana onde di luce dorata, bolle in risalita, anelli di pietra fluttuanti e onde d'urto che ondeggiano nel corpo idrico.
Questa è la frase con la leva più alta del prompt. Senza una destinazione scritta, un piano sequenza di 15 secondi continua fino a dissolversi. Dare al modello un evento "infine" esplicito, con il suo budget di dettagli — onde di luce, anelli di pietra fluttuanti, onde d'urto — dà al video un arco: viaggio, arrivo, chiusura culminante. Nel render finale Seedance scandisce il ritmo del tratto del corridoio in modo che la rivelazione cada negli ultimi secondi, che è esattamente l'effetto che un video showcase dovrebbe avere.
4. Definire la color grading prima del render
Inquadratura POV continua, senza tagli... motion blur cinematografico, nebbia subacquea volumetrica, fasci di luce caustica, contrasto blu profondo e oro, VFX fantasy di alto livello, atmosfera epica e misteriosa...
Colore e texture: specificarli in anticipo costa molto meno che pentirsene dopo. "Contrasto blu profondo e oro" fissa la palette per tutto il video; motion blur e fasci di luce caustica lo fanno sembrare una ripresa subacquea reale anziché un'animazione fly-through di un motore grafico. E "inquadratura POV continua, senza tagli" dichiara esplicitamente il vincolo del piano sequenza — non aspettatevi che il modello lo deduca da "prima persona".
5. Comporre la colonna sonora nello stesso prompt
Audio: rombo subacqueo profondo, suono turbolento della pressione dell'acqua, bolle che sfrecciano accanto, risonanze lontane simili a quelle delle balene, il meccanismo di pietra che si risveglia, impatti cinematografici bassi e profondi, impulso di energia dorata alla rivelazione finale.
Seedance 2.0 genera nativamente l'audio sincronizzato (generate_audio è true per impostazione predefinita). Scrivete la riga audio come una seconda descrizione della scena: prima l'ambiente sonoro (rombo, pressione dell'acqua), poi gli eventi legati alle immagini — "il meccanismo di pietra che si risveglia", "impulso di energia dorata alla rivelazione finale". Poiché gli eventi sonori sono descritti come parte degli stessi momenti, cadono dove avvengono gli eventi visivi. Il video qui sopra usa l'audio così come è stato generato.
6. Chiudere con una lista di negazioni
Nessun testo leggibile, nessun essere umano, nessun logo, nessuno stile cartoon, nessuna telecamera tremolante di bassa qualità.
La lista di negazioni è il contratto di qualità. Testo e loghi sono i difetti più comuni nelle scene di rovine e monumenti — i modelli amano particolarmente incidere caratteri casuali sulla pietra — e una sola figura umana di troppo rovina l'impressione di "mondo perduto". Vietate solo ciò che renderebbe inutilizzabile questo materiale, senza aggiungere altro.
Eseguirlo su hiapi
Una chiamata asincrona per il task, poi il polling:
# 1. 创建任务
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2-0",
    "input": {
      "prompt": "Immersive first-person gliding camera perspective, ...(上方完整提示词)",
      "aspect_ratio": "16:9",
      "duration": 15,
      "resolution": "4k",
      "generate_audio": true
    }
  }'

# 2. esegui il polling finché status = success, poi scarica output[0].url
curl https://api.hiapi.ai/v1/tasks/$TASK_ID \
  -H "Authorization: Bearer $HIAPI_TOKEN"
Due note pratiche:
- Il costo è al secondo e varia con il livello di risoluzione. A luglio 2026: 480p a $0.136/secondo, 720p a $0.293/secondo, 1080p a $0.729/secondo, 4k a $1.486/secondo. Questa esecuzione da 15 secondi in 4K costa circa $22; lo stesso prompt a 720p costa circa $4.40. Flusso consigliato: iterare la composizione a 720p, poi rieseguire una volta la versione finale scelta in 4k. I livelli attuali sono elencati nella pagina del modello Seedance 2.0.
- Il 4K è lento. Un render di 15 secondi in 4K può richiedere decine di minuti end-to-end — questa volta ci è voluta più di mezz'ora. Fate polling a intervalli ampi, senza martellare ripetutamente l'endpoint dei task. La tabella completa dei parametri (primo/ultimo frame, immagini di riferimento, aspect ratio) è nella guida API di Seedance 2.0.
FAQ
Seedance 2.0 riesce davvero a mantenere un'unica inquadratura per 15 secondi?
Sì. 15 secondi è la durata massima del modello; se il prompt lo richiede ("inquadratura POV continua, senza tagli") e dà alla telecamera un percorso con una destinazione, può mantenere un singolo movimento per tutta questa durata. Le durate lunghe prive di questi due elementi tendono a introdurre tagli.
L'audio proviene dalla stessa generazione?
Sì — generate_audio è true per impostazione predefinita, e la riga Audio: nel prompt guida il mix. Niente di ciò che si vede nel video qui sopra è stato aggiunto in post-produzione.
Dovrei generare direttamente in 4k?
Fallo solo per la versione finale. I problemi di composizione, ritmo e tempistica della rivelazione si vedono chiaramente a 720p, a circa un quinto del prezzo al secondo del 4K. Itera lì, poi renderizza una volta in 4k.
E se mi servono più di 15 secondi?
Seedance 2.5 porta la generazione a singola inquadratura fino a 30 secondi — per le altre novità vedi Seedance 2.5 vs Seedance 2.0. Per la maggior parte dei lavori showcase, però, 15 secondi con una rivelazione scritta bastano.
Sentitevi liberi di usare il prompt qui sopra. Sostituite il tempio con un canyon a fessura, un relitto, una sala server — mantenete i sei compiti: bloccare la telecamera, vietare i supporti, stratificare il corridoio, scrivere il finale, definire la color grading, comporre il suono. Poi eseguitelo su Seedance 2.0 su hiapi e scoprite dove porta il vostro corridoio.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori