
使用ガイド
Seedance 2.5 公式ユーザーマニュアル:30 秒生成、180 秒長尺動画とプロンプトの公式
Dreamina Seedance 2.5 中国語完全ガイド:パラメータ制限、30〜180 秒の長尺動画、動画延長、タイムスタンプ制御、Smart Edit、マルチモーダル参照、実写人物プロンプトとクレイレンダリング。
1. 即夢 Seedance 2.5 正式リリース
Dreamina Seedance 2.0 がマルチモーダル創作の扉を開いてから、私たちはクリエイターに究極の「コントロール力」とより広大な物語空間を届ける方法を探求し続けてきました。本日、Dreamina Seedance 2.5 が正式に登場し、プロ創作の新たな基準となります!
Dreamina のマルチモーダルを振り返ると:Seedance 2.0 は画像、動画、音声、テキストの 4 種類の入力モードをサポートしています。
Dreamina Seedance 2.0 で「監督」になる楽しさを味わったのなら、Dreamina Seedance 2.5 は万能のプロ用デジタル撮影所をあなたに提供します:より長く、よりリアルに、より言うことを聞く。創作が本当に「狙ったところを打ち抜く」ものになります。
Seedance 2.0 に対するユーザーの最も集中したフィードバックに応え、私たちは全面的な最適化を行いました。
2. パラメータ設定
Dreamina Seedance 2.5 では、マルチモーダル生成能力が全面的にアップグレードされました。システムは引き続き先頭フレーム、先頭・末尾フレーム、マルチモーダル参照入力に対応しつつ、参照素材の数量と時長の制限を大幅に緩和し、さらに音声のみによる駆動を新たに追加しました。創作に、より柔軟でより広大な空間を提供します。
画像
| 項目 | 制限 |
|---|---|
| 数量 | 1 回につき最大 30 枚 |
| 形式 | JPEG、PNG、WebP、BMP、TIFF、GIF、HEIC、HEIF |
| アスペクト比 | 0.4-2.5 |
| 辺の長さ | 300-6000 px |
| 1 枚のサイズ | 30 MB 未満 |
公式の安定性の推奨:主体画像に 1〜8 個の主体が含まれる場合が最も良い結果となります。9〜12 個でも試せますが、安定性は低下します。同じ主体に複数の視角が必要な場合は、複数の視角を 1 枚の画像にまとめるよりも、複数の単一視角画像に分割する方が通常は安定します。
動画
| 項目 | 制限 |
|---|---|
| 数量 | 最大 10 本 |
| 1 本の時長 | 2〜30 秒(実際の許容範囲は約 1.8〜30.2 秒) |
| 合計時長 | 30 秒以内(実際の許容範囲は約 30.2 秒) |
| 形式 | MP4、MOV |
| 解像度 | 480p-4K |
| フレームレート | 24-60 FPS |
| 1 本のサイズ | 200 MB 以内 |
動画編集に使用する場合、公式は元動画を 20 秒以内に抑えることを推奨しています。参照画像は 1〜5 枚が通常より安定し、6〜8 枚も試せますが、複数回の生成による選別に依存する度合いが高まります。
音声
| 項目 | 制限 |
|---|---|
| 数量 | 最大 10 本 |
| 1 本の時長 | 2〜30 秒 |
| 合計時長 | 30 秒以内 |
| 形式 | WAV、MP3 |
| 1 本のサイズ | 15 MB 以内 |
| 音声のみによる駆動 | 対応。画像や動画との組み合わせは必須ではありません |
出力
- 標準生成時長:4〜30 秒、約 97〜721 フレームに相当。
- 出力解像度:480p、720p。
- 長尺動画:Long Video に切り替えると 30〜180 秒を選択可能。
3. 機能インタラクション
4 種類の創作モード
Dreamina の AI Video ページに進み、Dreamina Seedance 2.5 を選択すると、モードメニューから切り替えられます:
- Omni Reference:画像・動画・音声のマルチモーダル参照。
- Smart Edit:動画をアップロードしてテキストで修正。
- Long Video:一度に 30〜180 秒の長尺動画を生成。
- First and last Frames:先頭・末尾フレームによる制約。
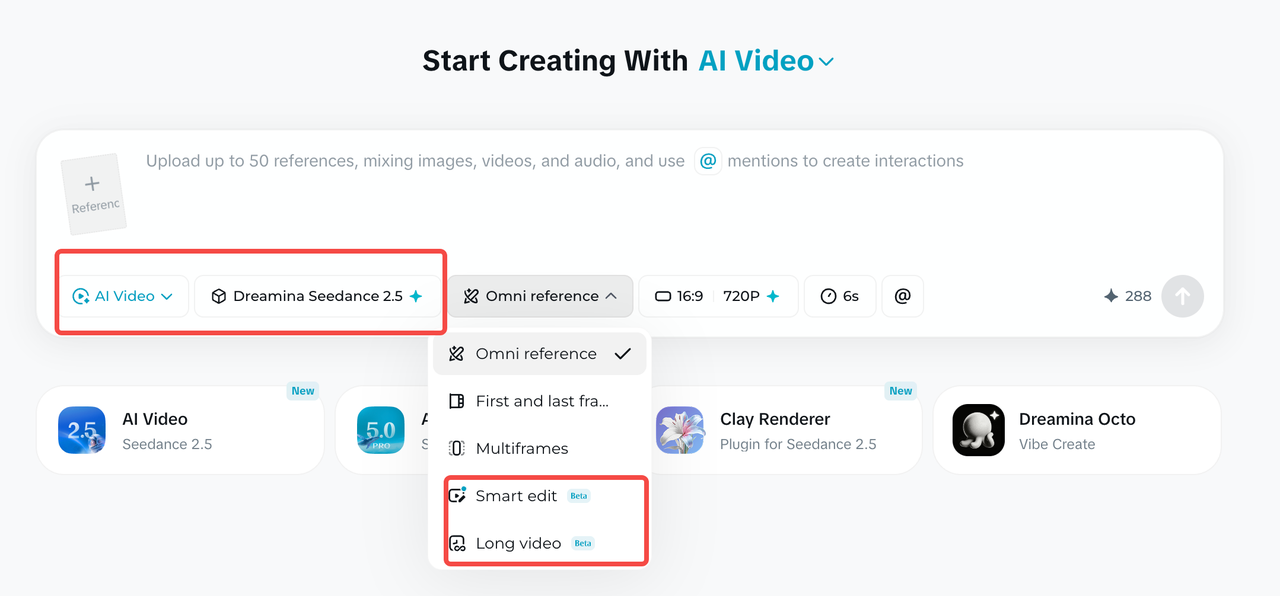
Long Video:一度に 30〜180 秒を生成
- 完全な動画スクリプトまたはプロンプトを入力します。
- デフォルトで Omni Reference と表示されている可能性があるモードメニューを開き、Long Video を選択します。
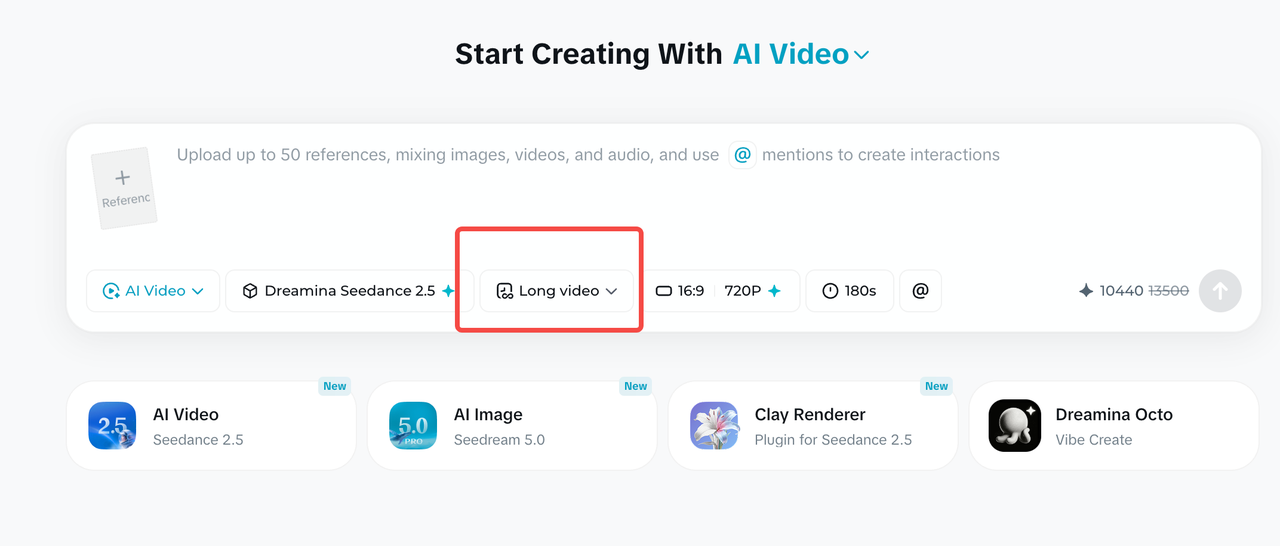
- ツールバーの時計アイコンをクリックします。
- タイムラインをドラッグするか数値を直接入力し、30〜180 秒を選択します。
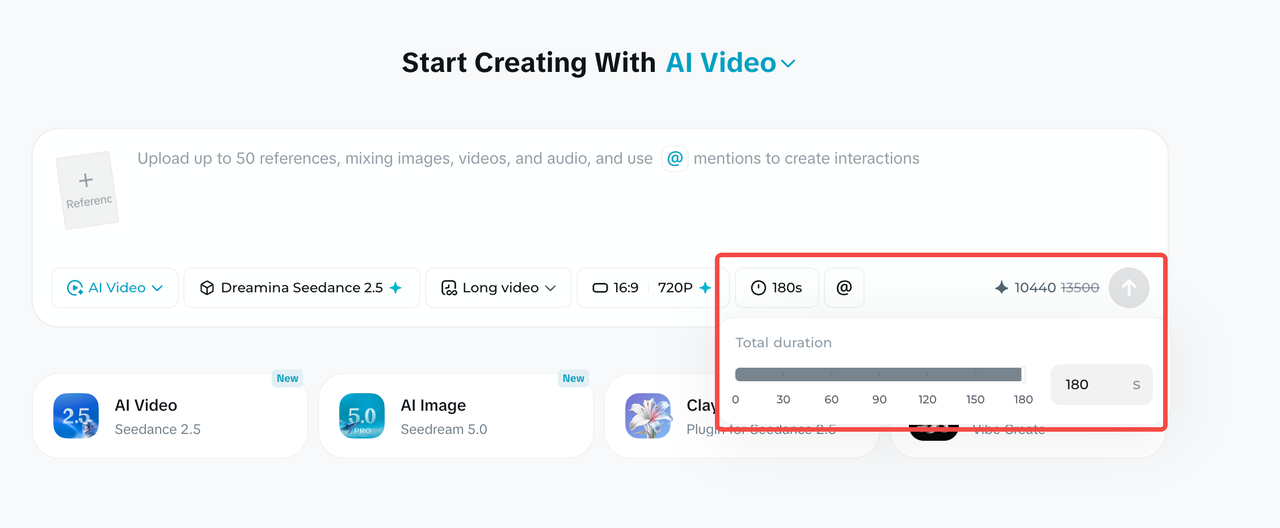
- アスペクト比、解像度、時長を確認し、Generate をクリックします。
Extend Video:動画を連続的に延長
Extend Video は30 秒以内の元動画にのみ利用可能です。毎回 4〜30 秒の追加時長を選択でき、プロンプトは追加部分のみを記述します。
- 生成フローで対象の動画を選択し、下部の Extend Video をクリックします。
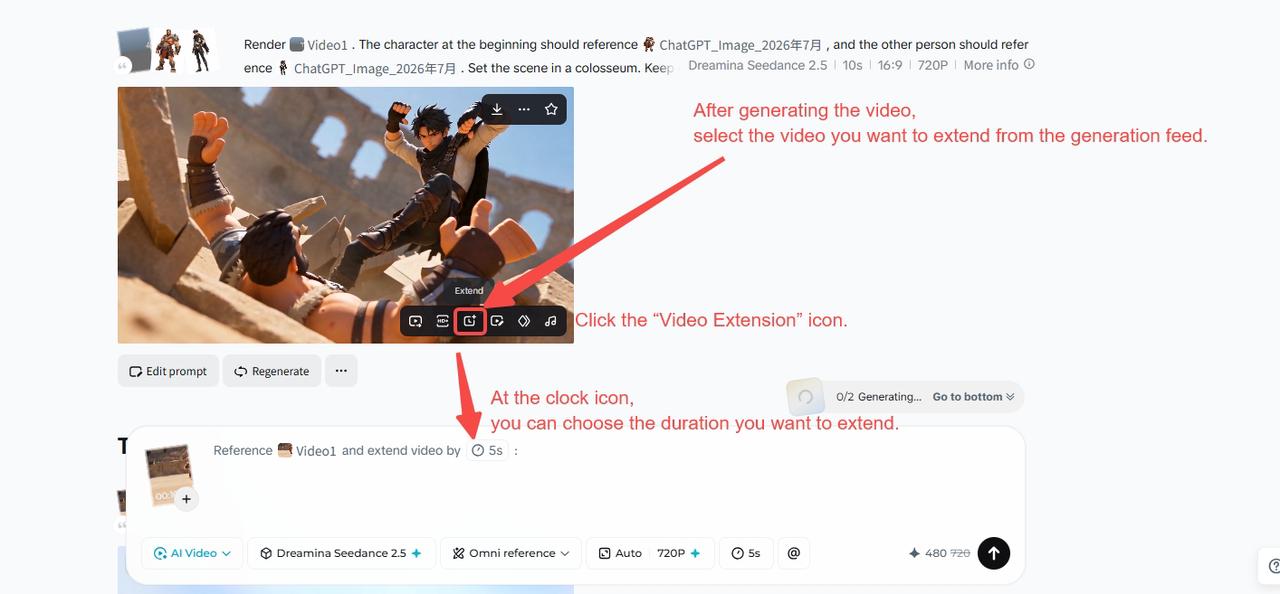
- 時計をクリックし、タイムラインをドラッグするか追加時長を入力します。
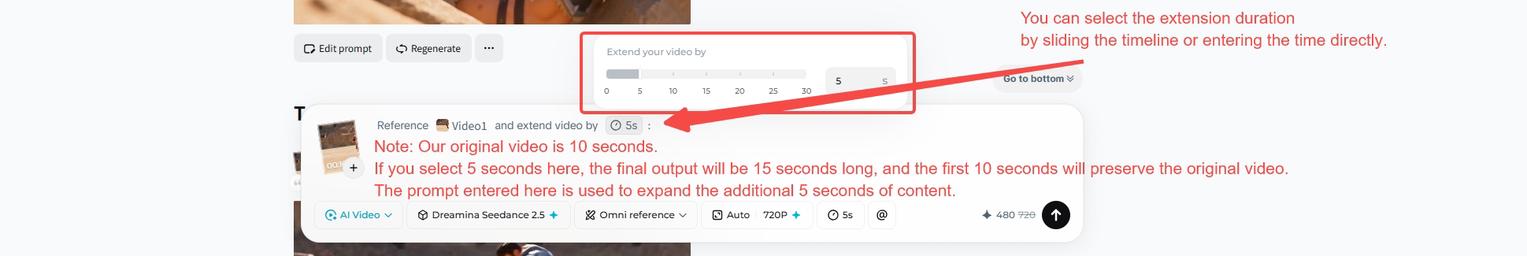
- テキストボックスに追加段落の画面、動作、つなぎ方を書き、完全な動画を生成します。
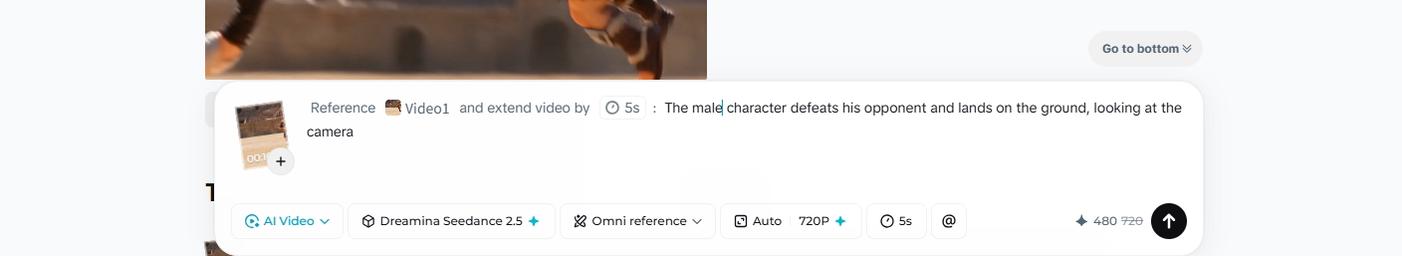
公式の英語サンプルを以下にそのまま掲載します:
Reference the content of @video1, extend the video by 10s to continue the story. Require to use a "mask transition" at the cut (hard cuts are prohibited, objects appearing out of thin air are prohibited). Shot A shows the muscular warrior in @image1 who is defending (close-up), a gust of wind blows, a normal-sized fallen leaf drifts towards the camera, the leaf completely covers the camera causing the full screen to go dark; then the camera pulls back through the leaf, directly revealing the next scene: the young ranger in @image2 is leaning against a tree, raising his bow and arrow taking aim. Require the scene to be switched naturally. Naturally switch from the warrior's close-up to the ranger's medium shot.
Smart Edit:テキストで動画を修正
Smart Edit は、ブラシでマーキングする必要がなく、テキストで直接明確に説明できる修正に適しています。書き方は:
[具体的な修正対象] + [動作と変化の記述] + [有効な時間帯]
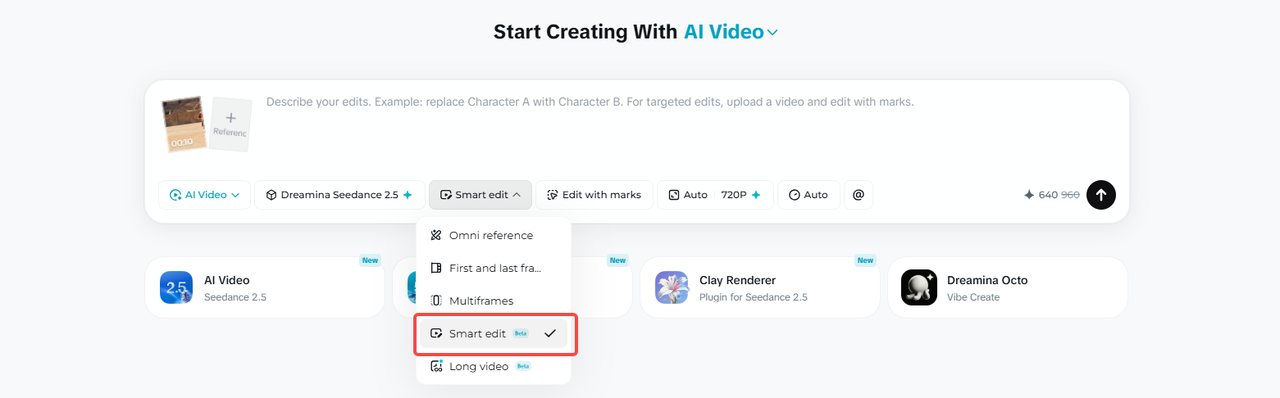
公式サンプル:
Modify everything entirely from 0 to 8 seconds of the overall video. Change the whale in the video to a white dragon. Remove the BGM.
Edit with marks:範囲選択して部分修正
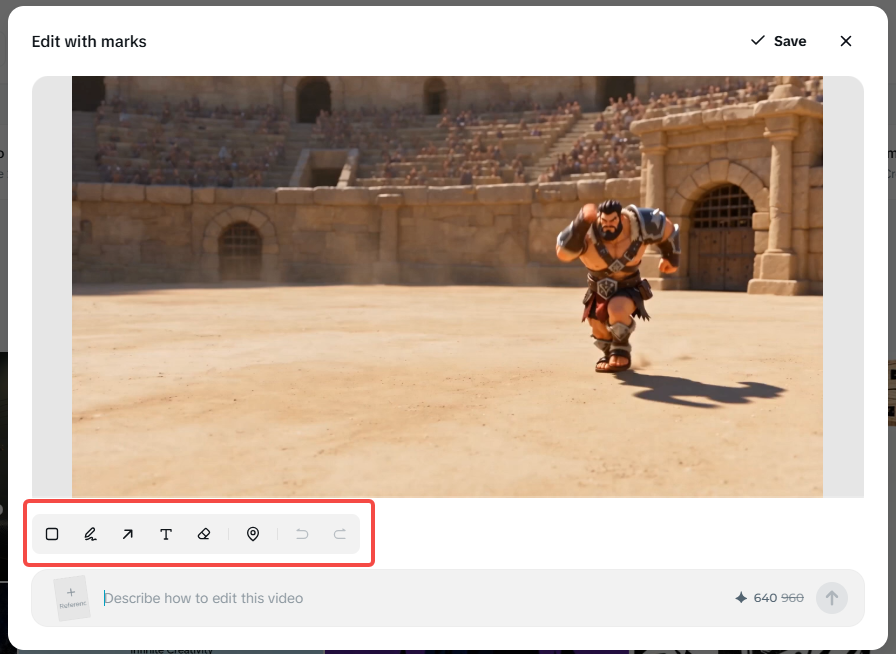
ローカル動画をアップロードすると、入力エリアに Edit with marks の入口が表示されます。これは「画面内のこの位置だけを変更する」場合に適しており、矩形選択、ブラシ、矢印、またはアンカーで対象をマーキングできます。
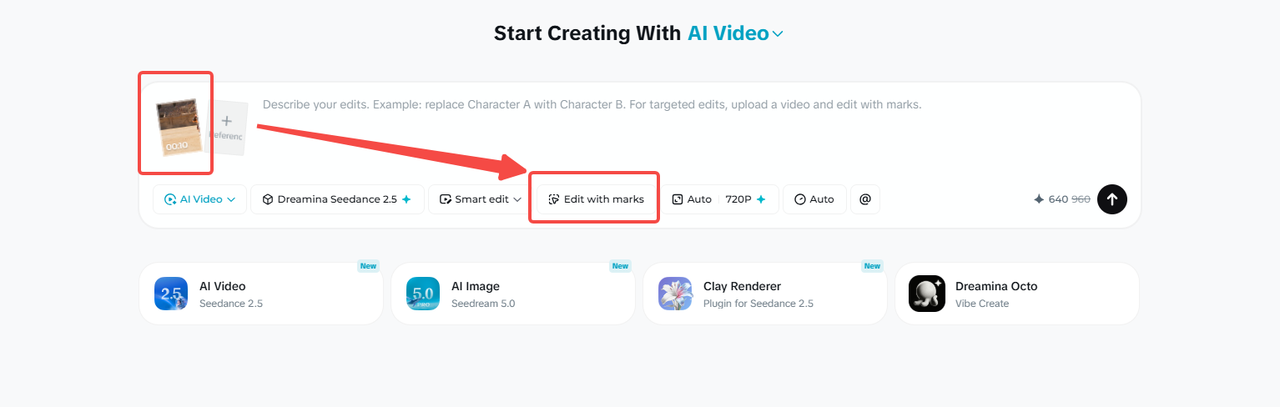
マーキング画面で対象を囲み、テキストの要件を補足して確認します。システムはマーキングフレームとタイムスタンプを入力に追加し、要件に従って全体または指定時間帯を修正します。
Edit Video:生成済みの動画を編集
Edit Video は生成フロー内の完成動画を対象としています。動画下部の編集入口を選択すると、キャラクターの差し替え、服装の変更、カメラポジションの調整、対象の除去、背景の変更を続けられます。Edit with marks との違いは主に入口にあり、前者は生成済みの完成動画を編集し、後者はローカルでアップロードした動画も処理できます。
4. 基本プロンプトの公式
公式が提示する基本プロンプトの公式:
完全なプロンプト = [素材説明] + [一言要約] + [具体的な筋書きの記述] + [全体補足]
| モジュール | 書き方 |
|---|---|
| 素材説明 | アップロード順に、各素材がキャラクター、シーン、動作、音色、カメラのいずれの参照に使われるかを明記 |
| 一言要約 | 主体 + 場所 + 出来事 + テーマ/スタイル + 特殊なカメラワーク |
| 具体的な筋書き | タイムラインに沿って画面、カメラワーク、動作、セリフ、効果音、トランジションを記述 |
| 全体補足 | カメラポジション、環境、照明、音、人物の一貫性、禁止事項を再度固定 |
公式の英語サンプル抜粋:
Realistic nature documentary style, cinematic realistic lighting. In the morning mist, within a vast wetland reed bed @image1, an elegant red-crowned crane is spreading its wings and dancing. @image2 The red-crowned crane features snow-white feathers, a bright red crown, a slender and upright posture, and light, noble movements.

0s-3s: A red-crowned crane stands quietly in the shallow water with an elegant posture. It slowly begins to unfold its broad black-and-white wings with gentle movements. The airflow from the flapping wings creates ripples on the water surface.

3s-8s: The red-crowned crane leaps lightly on the water, its feet alternately tapping the surface, splashing crystal-clear water droplets. Its slender neck tilts backward with its beak pointing to the sky.

Low-angle, slight handheld camera feel, moving up and down slightly to follow the crane's jumping trajectory. Natural environmental sounds: flowing water, the powerful flapping of wings, and the crane's call. The overall atmosphere is peaceful, ethereal, and highly aesthetic.
5. 実写人物の公式
実写人物のプロンプトの公式は以下の通りです:
Character = [Age/Race] + [Skin Color/Skin Texture] + [Facial Details] + [Eye/Soul] + [Hairstyle/Hair Color] + [Clothing/Clothing Texture] + [Body Type/Emotion/Temperament] + [Other Requirements]
中国語の公式:
キャラクター = 年齢/人種 + 肌色/肌の質感 + 五官の細部 + 眼差し/魂 + 髪型/髪色 + 服装/衣着の質感 + 体型/感情/気質 + その他の要件
公式におけるキャラクター情報には以下が含まれます:
- 肌:寒暖調、リアルな毛穴、細いしわ、そばかすや自然な瑕疵。
- 五官:目の形、眉骨、鼻筋、唇の形、頬骨と顎のライン。少なくとも 3〜4 項目。
- 眼差し:視線の方向、底にある感情、人物関係。
- 髪:具体的な髪色、質感、髪型、風に吹かれたり運動後の状態。
- 服装:仕立て、色、生地、新旧の状態、着こなしの細部。
- 体つき:骨格、肩のライン、構図、動作、全体的な気質。
公式の英語サンプル:
22-year-old East Asian woman, with a highly classical, gentle cinematic face. Cool-toned fair skin, revealing a delicate and moist texture, retaining realistic fine pores and natural skin texture. Slender and elegant eyes, a delicate and straight nose bridge, full lips with a faint, gentle smile at the corners, and a soft jawline. Extremely affectionate and expressive gaze, eyes shimmering like spring water. Jet-black hair pinned into a casual yet elegant classical low bun, secured only by a plain jade hairpin. Wearing a minimalist, pure white traditional cross-collar dress. Slender figure with delicate narrow shoulders, exuding a gentle, graceful, and deeply affectionate classical romantic aura.
6. タイムスタンプ制御
Seedance 2.5 はテキストで具体的なタイムスタンプを指定することをサポートしています。クリエイターは指示を具体的な秒数まで正確に指定し、画面内の動作の展開やシーンの切り替えを制御して、スクリプトレベルの精密な再現を実現できます。
公式の英語タイムスタンプサンプル:
0-5s: Open with a close-up of the Overlord from @Image 2. The camera slowly circles his upper body and transitions into a medium shot. The Overlord spins and turns, his body and back flags sweeping quickly past the lens to form a natural occlusion.

6-10s: The camera steadily circles Consort Yu in a medium shot from @Image 1, following her water sleeves through the arc. She raises her arm, flicks her wrist, unfurls the sleeves, and half-turns.

11-20s: The male warrior from @Image 3 enters with an aerial flip. The camera slowly pulls back from a medium-close shot of the warrior to a full stage view. At the end, all three face the audience and strike a synchronized Peking opera finale pose.
7. 多言語動画
Seedance 2.5 は小語種の入力を全面的にサポートし、中国語、英語、スペイン語、インドネシア語、マレー語を優先的に最適化し、タイ語、アラビア語、ポルトガル語、ベトナム語、日本語、韓国語もカバーします。異なる言語のクリエイターは、自分が最も慣れ親しんだ母語で直接アイデアを表現できます。
8. 字幕とBGMの除去
Seedance 2.5 は生成の安定性を大幅に最適化し、ランダムな字幕や無関係なBGMの問題を効果的に解決し、後から自分で文字や音楽を追加するためのよりクリーンな基礎映像素材を提供します。
BGMを削除し、元動画の人の声やその他の要素を保持する場合は、以下を使用できます:
Remove the background music from @Video 1. Keep the original dialogue, voice, ambient sound, and on-screen subtitles unchanged.
9. マルチモーダル参照のアップグレード
1 回につき最大 30 枚の画像、10 本の動画、10 本の音声を入力できます。アップグレードは数量の増加だけでなく、以下も含みます:
- 参照動画の動作、カメラ言語、感情の雰囲気、クリエイティブな構造を転移。
- BGMを分離または削除し、人の声と画面要素を保持。
- 部分的な消去、対象の差し替え、空間視角の変更。
- より多くの音色を参照し、複数人が同じ画面にいる場合の身元の独立性を向上。
- グリーンバック編集、シームレスな動画トランジション、マルチグリッドの絵コンテ参照。
10. Clay Renderer クレイレンダリング
Clay Renderer を使用すると、Maya、Blender などの 3D ワークフローで、まずマテリアルのないクレイモデルで空間構造、人物の立ち位置、運動経路、カメラポジションを確定し、その後モデルにマテリアル、照明、スタイルを補完させることができます。
プロンプトの公式:
[クレイモデル参照の内容] + [キャラクター/シーン参照] + [マテリアルと照明] + [スタイル] + [完全なストーリーの順序]
公式の英語サンプル:
Refer to @Clay Render 1 for camera movement, pacing, shot-size transitions, subject trajectory, and blocking. Refer to @Image 2 for character design, scene, materials, lighting, color, and fairy-tale atmosphere, and render the white model as a dreamy, warm, 3D animated short with a childlike fantasy feel. The story unfolds as follows: flight through a fantasy sky → mythical beasts flying alongside through a sea of clouds → a dive into the ocean → weaving through the deep with manta rays → passing through a mirrored rift in spacetime → picking stars from the cosmos → transforming back into the bedroom → father tucking in the blanket → the picture book closes and holds on the final frame.
11. 公式の素材入力の推奨
| シーン | 公式の推奨 |
|---|---|
| 素材入力の上限 | 画像は最大 30 枚、4K 対応;動画は最大 10 本、合計時長 30 秒以内;音声は最大 10 本、合計時長 30 秒以内。 |
| 音声・動画の主体数 | 1〜5 個の主体が最も良い結果となります。6〜10 個の主体も試せますが、安定性が低下し、複数回の生成が必要になる場合があります。 |
| 音声・動画の主体時長 | 5〜10 秒が最も良い結果となります。時長が増えると安定性が低下し、複数回の生成が必要になる場合があります。 |
| 主体画像の数 | 1〜8 個の主体が最も良い結果となります。9〜12 個の主体も試せますが、安定性が低下し、複数回の生成が必要になる場合があります。 |
| 異なる視角の主体画像 | 1〜5 個の主体の場合は、単一視角も複数視角も可能です。5 個を超える主体の場合は単一視角の方が安定します。複数の視角が必要な場合は、複数の視角を 1 枚の画像に入れず、複数の異なる視角の画像に分割することを推奨します。 |
| 動画編集の時長 | 20 秒以内が最も良い結果となります。時長が増えると安定性が低下し、複数回の生成が必要になる場合があります。 |
| 動画の参照画像数 | 1〜5 枚の参照画像が最も良い結果となります。6〜8 枚も試せますが、安定性が低下し、複数回の生成が必要になる場合があります。 |
12. FAQ
最長でどれくらいの長さの動画を生成できますか?
Dreamina の Long Video モードは一度に 30〜180 秒、最長 180 秒の生成をサポートします。標準の単回生成は 4〜30 秒です。Extend Video は 30 秒以内の元動画に 4〜30 秒を追加でき、複数回の組み合わせで最長 60 秒まで可能です。
一度にどれくらいの参照素材をアップロードできますか?
最大 30 枚の画像、10 本の動画、10 本の音声です。動画と音声はそれぞれ合計時長 30 秒以内です。数量は上限であり、安定性の推奨ではありません。複雑なタスクでは、少ない素材から始めて徐々に増やすことを推奨します。
人物の AI 感を減らすには?
「実写、映画的」とだけ書かないでください。年齢/人種、肌色と毛穴、五官、眼差し、髪型、服装の素材、体型と気質を項目ごとに記述し、そばかす、細いしわ、乱れた髪の毛、衣料の摩耗などのリアルな細部を保持します。複数人のシーンでは、各人に独立した顔の形、髪色、服装、立ち位置を与えてください。
タイムスタンプで長尺動画を制御するには?
まず全体設定を書き、次に時長を連続的で重複しない区間に分割します。例えば 00:00-00:06、00:07-00:13 などです。各区間にそれぞれカメラ、主体の動作、セリフ/音声、トランジションを書き、最後に全体の一貫性と禁止事項を補足します。
HiAPI で今すぐ Seedance 2.5 を直接呼び出せますか?
できます。 Seedance 2.5 は HiAPI にて提供開始済みで、モデルは seedance-2.5/text-to-video、seedance-2.5/image-to-video、seedance-2.5/reference-to-video です。テキストto動画と画像to動画は 720p で毎秒 $0.204、1080p で毎秒 $0.516;参照to動画は 480p で毎秒 $0.1215 からで、「参照動画時長 + 出力時長」で課金されます。API の単一タスクでは 4〜30 秒を生成できます。長尺動画、延長、スマート編集は即夢 App の機能です。
API で接続する場合は、お手元の素材に応じて対応する中国語チュートリアルをお選びください:
- プロンプトのみ:Seedance 2.5 テキストto動画 API チュートリアル
- 先頭フレームまたは先頭・末尾フレームの画像がある:Seedance 2.5 画像to動画 API チュートリアル
- 参照動画があり、カメラワークを流用して主体を変えたい:Seedance 2.5 参照to動画 API チュートリアル
仕様と価格の詳細は Seedance 2.5 詳解 と Seedance 2.5 API 価格 をご覧ください。


